




声网联合美团与xbench发布AI外呼智能体评测基准

声网联合美团、xbench发布AI外呼智能体评测基准VoiceAgentEval,从基准测试构建、用户模拟器、交互质量评估三方面系统评估大模型性能。覆盖六大业务领域30个子场景,模拟150种用户人设。测试表明Doubao-1 5-32k、GPT-4 1、Claude-4-Sonnet位列前三,推动模型评测从学术榜单走向业务场景。
生成式人工智能在客服领域的落地速度,远超许多人的预期。如今的AI外呼已不再是过去那个只会机械念稿的“语音机器人”,而是逐步演变为企业优化客户沟通、提升运营效率的核心工具。从招聘、销售到售后服务,其应用版图不断扩展,几乎成为生成式AI落地最广泛的场景之一。
与此同时,对话式AI技术也在加速成熟,AI外呼正从“能通话”向“会沟通、懂需求”的专家级交互升级。然而,一个尴尬的现实摆在眼前:业内虽然不乏像MMLU、C-Eval这样的通用学术评测榜单,但针对智能外呼这个具体场景,一直缺少一套全面、客观的评估标准。这就好比大家都在造车,却没有一个统一的“路考”来判断哪辆车真正能开好。
正是在这个背景下,声网联合美团和xbench,共同推出了专门用于评估大模型在AI外呼场景下性能表现的评测基准——VoiceAgentEval。它的目标很明确:填补行业空白,让从业者能清晰地看到,在真实的业务环境中,各家大模型到底有几斤几两,并为技术落地和体验优化提供核心参考。
现有的评测标准,要么关注的是通用对话能力,要么只盯着单轮指令遵循,普遍存在数据集量和类别覆盖不足、用户模拟不够真实、评估指标不够精准等问题。而VoiceAgentEval得益于三方在对话式AI、外呼业务场景和AI基准评测领域的深厚积累,从“基准测试构建”、“用户模拟器”和“交互质量评估方法”三个维度,对AI外呼能力进行了系统性评估。它的框架有几个关键特点:
首先是基准测试构建。它建立了一个基于真实外呼业务数据的语料库,覆盖了客服、销售、招聘、金融、调研、主动关怀与通知六大业务领域,细分为30个子场景。每个子场景都配有详细的评估方案,包括特定的流程分解、加权评分系统和领域自适应指标——这为后续的细致评估打下了扎实根基。
其次是用户模拟器。通过利用真实业务场景的交互数据,研发团队构建了大量稳定且有效的用户模拟器。这让测试能在可控、可复现的环境中进行,从而考察模型在面对不同沟通风格时的任务完成能力。
最后是评估方法。它建立了“文本+语音”双维度评估体系。文本层面,开发了一套双层评估系统,包括任务流程遵循和一般交互能力,通过标准化场景设计和定量评分机制实现精准评估。语音层面,则在三大场景中建立了15个指标,整合了专家评分和客观数据,为语音识别准确性、音频质量和交互体验提供多维度的量化衡量。
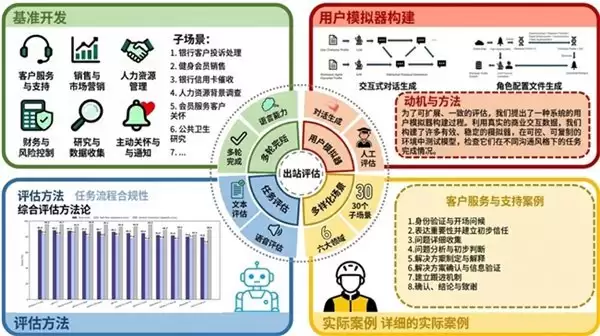
图:VoiceAgentEval 评测框架示例
用户模拟器:模拟150种人设的用户与AI客服进行虚拟对话
外呼任务中,目标用户的多样性和不可预测性是最大的变量——这个道理,做过外呼的人都懂。为了让评测能做到规模化且稳定,美团主导构建了用户模拟器:用AI来模拟用户,然后验证Agent的任务完成度。
具体做法是,先基于真实业务场景中的交互数据,利用大模型提取并泛化出典型的用户画像特征;然后模拟出五组不同行为模式、知识背景和对话策略的用户,并将其与30个真实业务子场景结合,形成150组不同设定下的消费者用户。这些模拟用户会与AI接听者进行虚拟对话。这样一来,整个测试就能在一个受控且可复现的环境中进行,检验模型在不同沟通风格下的应变能力。
为了严格评估这150组模拟对话与真实对话的接近程度,美团采用了三种方法:
- 拟人度分数评估:基于语言自然性、不完美性和情绪合理性,采用图灵测试启发的0-9分制进行打分。
- AI检测评估:由大模型来判断当前对话中的用户是否为AI生成。
- 配对比较评估:随机配对一条AI生成的对话和一条真实外呼对话,让大模型驱动的AI文本检测师来判断,哪一条更可能是AI生成的。
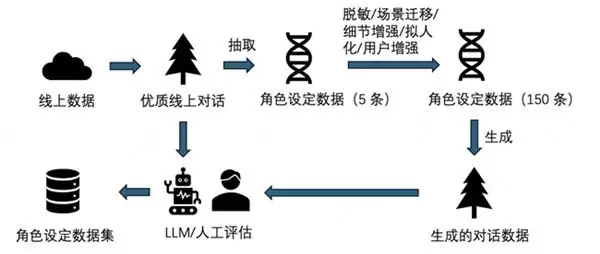
图:用户模拟器构建流程图
AI外呼能力评估:任务流程遵循度与通用交互能力
在成功模拟消费者与AI对话之后,接下来就是评估大模型在外呼场景中的真实表现了。核心聚焦在两个维度:任务流程遵循度和通用交互能力。
任务流程遵循度,主要通过覆盖分数和流程分数来衡量。覆盖分数看的是关键节点与完整节点的完成率,流程分数则关注任务执行序列的正确性、业务逻辑是否被遵循、有没有程序违规等。简单说,就是看模型能不能严格按照外呼SOP(标准作业程序)完成任务,能不能准确理解和执行特定业务流程。
而通用交互能力的评估,则依托声网的对话式AI引擎构建了一个真实可运行的智能体评测平台。凭借声网在实时音视频与对话式AI领域的技术积累,重点考察多轮对话、ASR(自动语音识别)、TTS(文本转语音)三个关键节点的响应延迟、打断成功率、准确率、音质、交互体验等多个指标。最终,这些数据会反映出Agent在复杂业务环境中的真实对话能力。
值得一提的是,声网在去年10月就上线了对话式AI引擎2.0版的电话外呼功能,通过对话式AI Studio编排,甚至一行代码就能完成集成,稳定性很高。目前已有不少零售、医疗健康企业接入了这项能力,这为VoiceAgentEval的评测提供了扎实的技术积累和实战经验。
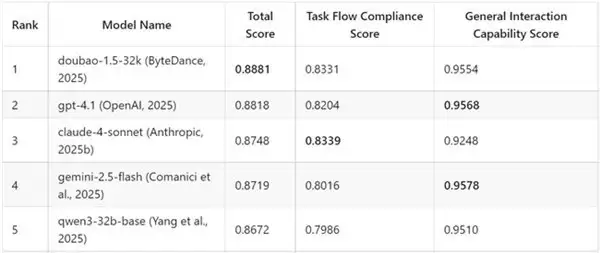
经过对任务流程遵循度与通用交互能力的综合评估,结果最终呈现出一个清晰的梯队:Doubao-1.5-32k、GPT-4.1、Claude-4-Sonnet位列综合性能前三名。这三款模型的任务完成能力都相当出色,其中Doubao-1.5-32k与GPT-4.1的语音交互体验同样表现优异,而Claude-4-Sonnet则稍逊一筹。
xbench作为红杉中国推出的AI基准测试工具,在评估模型在复杂任务中的实际表现与真实场景效用价值方面具备专业能力。它结合了声网与美团对AI外呼智能体的评测方式与结论,最终设计并在其官网上线了VoiceAgentEval。
VoiceAgentEval的发布,不只是为AI外呼从业者提供了一个理解模型“行为表现”的参考坐标。更重要的是,它推动了AI模型的评测从理想化的学术榜单,真正走向更贴近业务实际的场景化评测。这可能是这个基准最值得关注的价值所在。

游乐网为非赢利性网站,所展示的游戏/软件/文章内容均来自于互联网或第三方用户上传分享,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系youleyoucom@outlook.com。
 同类文章

台式机加装固态硬盘怎么选?三星9100 PRO深度解析
台式机升级存储常受限于系统启动慢、游戏加载卡顿与大文件传输延迟。本文基于三星9100 PRO的PCIe 5 0架构、14800MB s读取、13400MB s写入、2200K 2600K IOPS、1TB~8TB容量、第八代V-NAND与5nm主控、镍涂层散热与DTG技术、散热片版适配及魔术师软件,提供选购判断与安装兼容性要点,帮助读者评估是否值得一步到位升级。

宁德时代2026年中期分红61.8亿元,同比增35%,创历史新高
宁德时代发布2026年中期分红方案,总额达61 8亿元,同比增长35%。本文梳理分红具体安排、历史对比、业绩支撑及分红机制,帮助投资者评估公司现金流实力与股东回报策略。

企业硬盘报废销毁合规指南:如何选择专业机构与处理流程
企业硬盘报废面临数据复原与合规风险,需选择具备资质且流程透明的专业机构。本文解析行业乱象,介绍以团体标准为核心的合规销毁流程,涵盖上门收运、消磁粉碎、视频溯源及尾料处置,帮助企业规避泄密责任,确保数据安全闭环。

机密文件销毁找什么机构?认准团标参编与资质合规
机密文件销毁找什么机构?核心在于甄别服务商是否具备正规保密资质及是否参与行业标准制定。本文解析《商业秘密及敏感信息载体销毁通用规范》团标要求,提供筛选销毁机构的实操指南,帮助企业规避数据泄露风险,确保销毁流程合规可溯。

影石Insta360 X6全球首销登顶:8K全景画质与AI创作功能解析
影石Insta360 X6全球同步发售即登顶国内外主流平台销量榜首。本文解析其搭载的索尼定制方形大底传感器、4nm AI三芯架构及8K50fps画质,详解3D时光舱、AI导演等独家功能,探讨全景相机从专业工具向大众智能创作设备的演进趋势。


- 热门数据榜


 相关攻略
 2026-09-01 11:26
2026-09-01 06:41
2026-08-31 11:19
2026-08-31 11:19
2026-08-31 11:18
2026-08-31 11:18
2026-08-31 11:17
2026-08-31 11:17
热门教程
- 游戏攻略
- 安卓教程
- 苹果教程
- 电脑教程







