
优化条件判断:减少冗余分支与复杂条件表达式
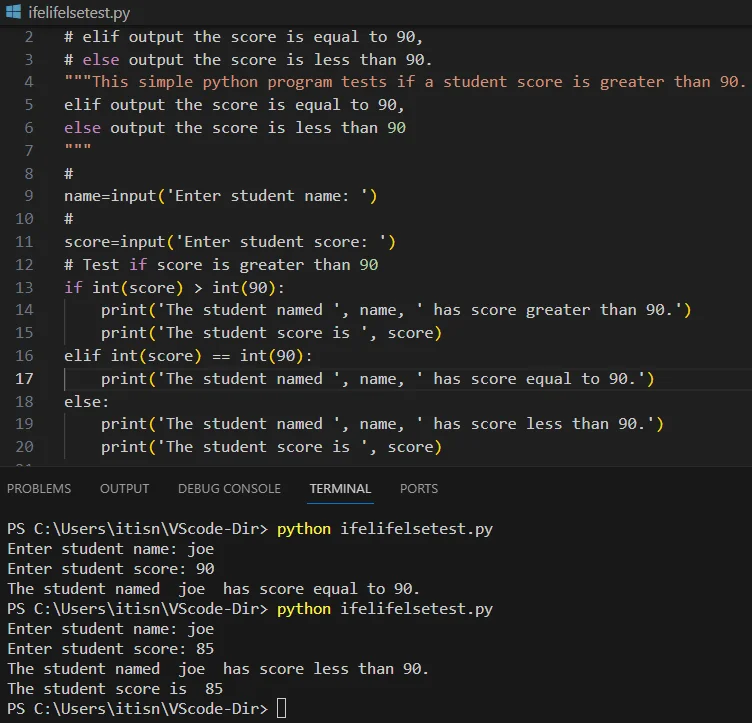
在 Python 中,条件判断的执行遵循自上而下、短路求值的原则。在实际开发中,过深的 if-elif-else 嵌套与重复的条件校验会显著降低代码可读性并增加不必要的 CPU 分支预测开销。优化核心在于“提前返回(Early Return)”与“逻辑扁平化”。例如,处理用户权限校验时,避免将多个条件层层包裹,可改为先判断非法状态并直接 return 或抛出异常,使主逻辑保持线性。对于复杂布尔表达式,应利用 and/or 的短路特性,将计算代价低或高概率为真的条件前置。同时,使用 in 操作符替代多个 == 的 or 组合,如 if status in ("active", "pending"): 不仅语义更清晰,底层 C 实现也更快。通过重构,代码分支层级通常可控制在三层以内,执行路径更明确,维护成本大幅降低。
提升循环性能:选择合适的遍历方式与循环结构
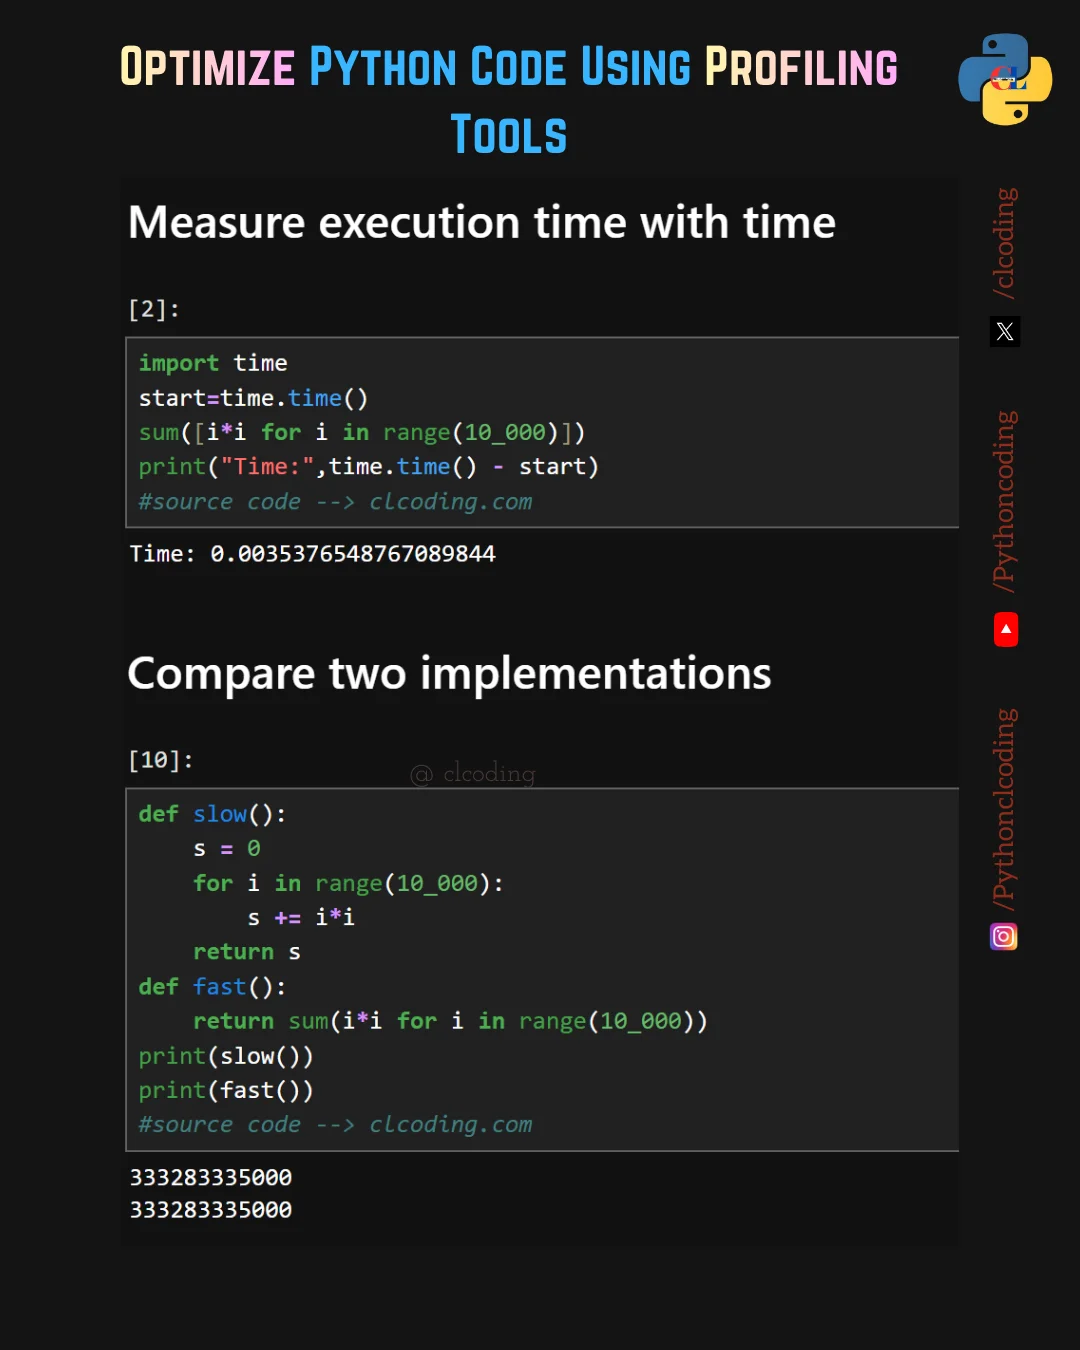
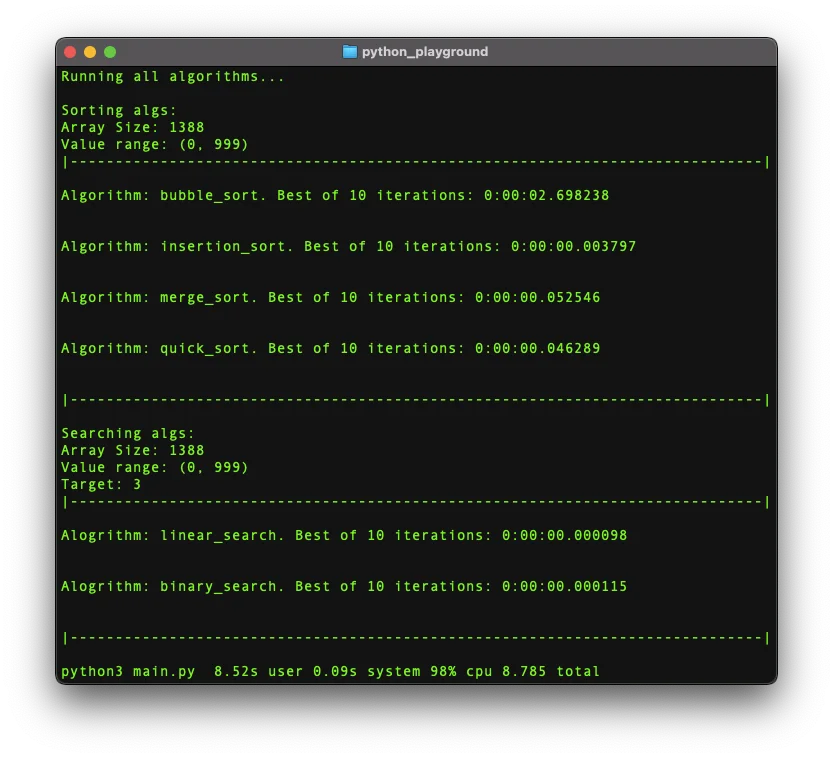
循环性能差异主要源于底层迭代协议与重复计算开销。在 Python 中,直接使用 for item in iterable: 比 for i in range(len(seq)): 更高效,因为后者每次迭代都需调用 len() 并通过索引访问,增加了函数调用与内存寻址成本。若需同时获取索引与元素,应优先使用内置的 enumerate()。此外,避免在循环体内执行不变量的重复计算,例如将正则编译、数据库连接或复杂数学运算移至循环外。对于成员资格检查,将列表转换为集合(set)可将查找时间复杂度从 O(n) 降至 O(1)。当需要生成新序列时,列表推导式或生成器表达式通常比显式 for 循环配合 append() 更快,因其底层由 C 语言优化。通过 timeit 模块对比不同写法的耗时,可直观验证结构选择对性能的实际影响。
掌握循环控制:break、continue 与循环 else 的最佳实践
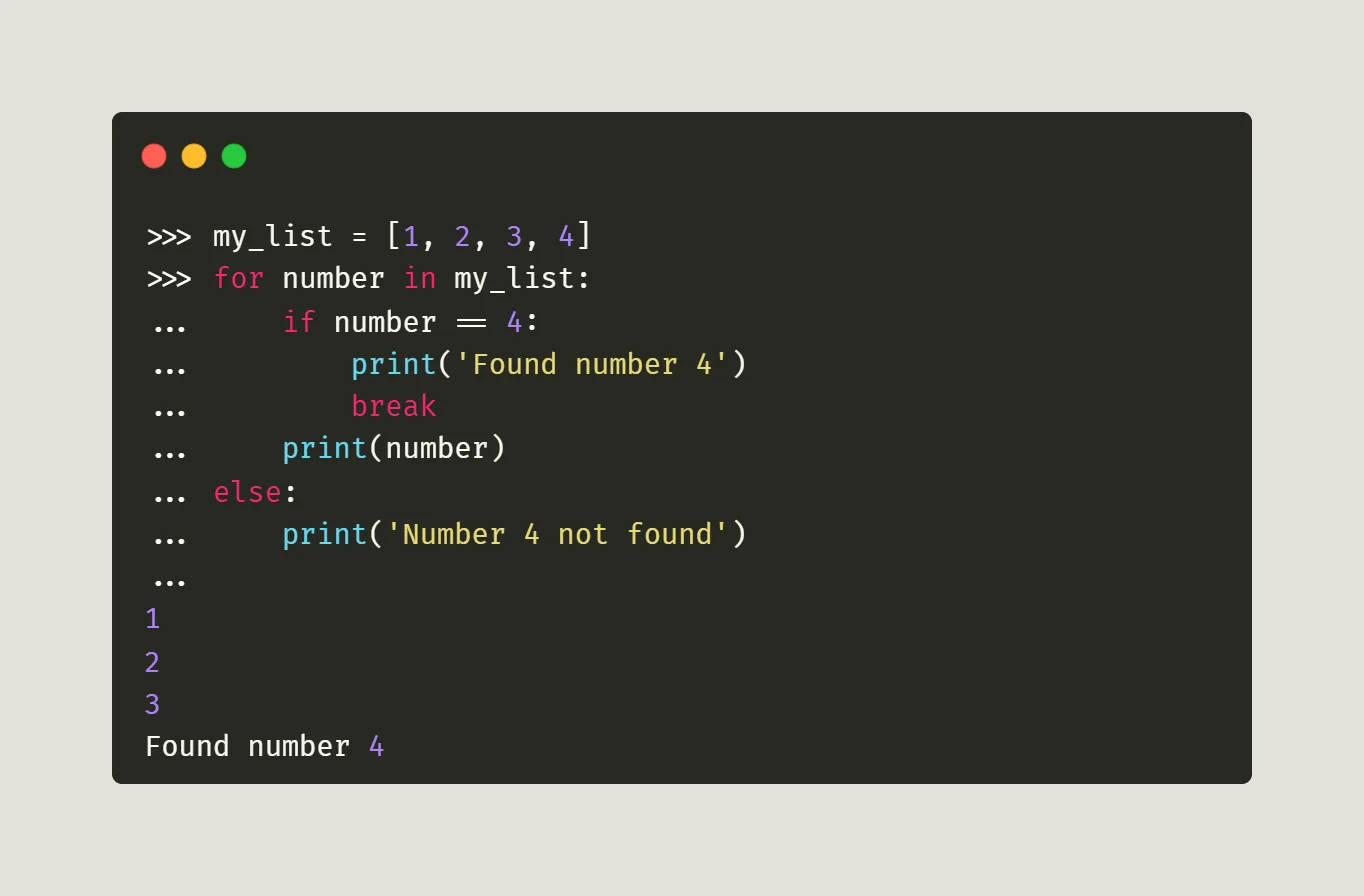
break、continue 与循环 else 是控制流的核心工具,但滥用易导致逻辑混乱。break 用于满足特定条件时立即终止整个循环,常用于搜索场景;continue 则跳过当前迭代剩余代码,直接进入下一轮,适合过滤无效数据。循环的 else 子句常被误解,其执行规则是:仅当循环正常结束(未被 break 中断)时才会触发。例如在查找目标元素时,若找到则 break 退出,此时 else 不执行;若遍历完毕仍未找到,则进入 else 块处理“未命中”逻辑,这比使用布尔标志变量更简洁。实践中,应确保 break 和 continue 的触发条件明确且单一,避免在深层嵌套中频繁跳转。结合清晰的注释与合理的函数拆分,可使控制流既高效又易于追踪。
排查高频陷阱:死循环、修改迭代对象与条件边界错误
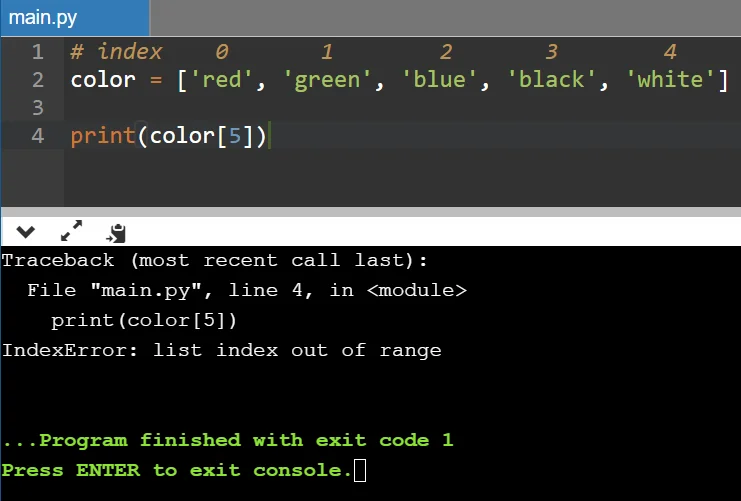
循环开发中常见陷阱包括条件未更新导致的死循环、遍历时修改容器引发的元素跳过,以及边界值处理不当。例如 while 循环若未在内部更新控制变量或设置合理的退出条件,将陷入无限执行,可通过添加最大迭代次数或超时机制进行防御。在 for 循环中直接调用 list.remove() 或 pop() 会改变底层索引,导致后续元素被跳过;安全做法是遍历副本(for item in lst[:])、使用列表推导式过滤,或倒序遍历。此外,range() 的边界易出现“差一错误”,需明确 start 包含、stop 不包含的特性,并通过打印边界值或编写单元测试验证。条件判断顺序也需合理,例如先检查空值再访问属性,利用短路求值避免 AttributeError。通过静态检查工具与边界用例测试,可有效拦截此类隐患。
综合验证与最佳实践:让优化后的代码更快、更清晰
代码优化的最终目标是兼顾执行效率、可读性与可维护性。验证优化效果需依赖客观数据:使用 timeit 或 cProfile 进行基准测试,对比优化前后的 CPU 耗时与内存分配;同时设计覆盖常规、空值、极值及异常输入的测试用例,确保逻辑正确性未被破坏。在规范层面,建议遵循 PEP 8 指南,保持条件表达式简洁,循环体尽量短小,复杂逻辑应封装为独立函数。避免“过早优化”,优先保证代码清晰,仅在性能瓶颈处进行针对性改进。建立团队代码审查清单,重点检查嵌套深度、冗余计算、迭代器滥用及边界处理。通过持续集成中的自动化测试与性能监控,可将条件与循环的最佳实践固化为工程标准,实现长期稳定的高质量交付。