
构建清晰的项目目录与模块导入机制
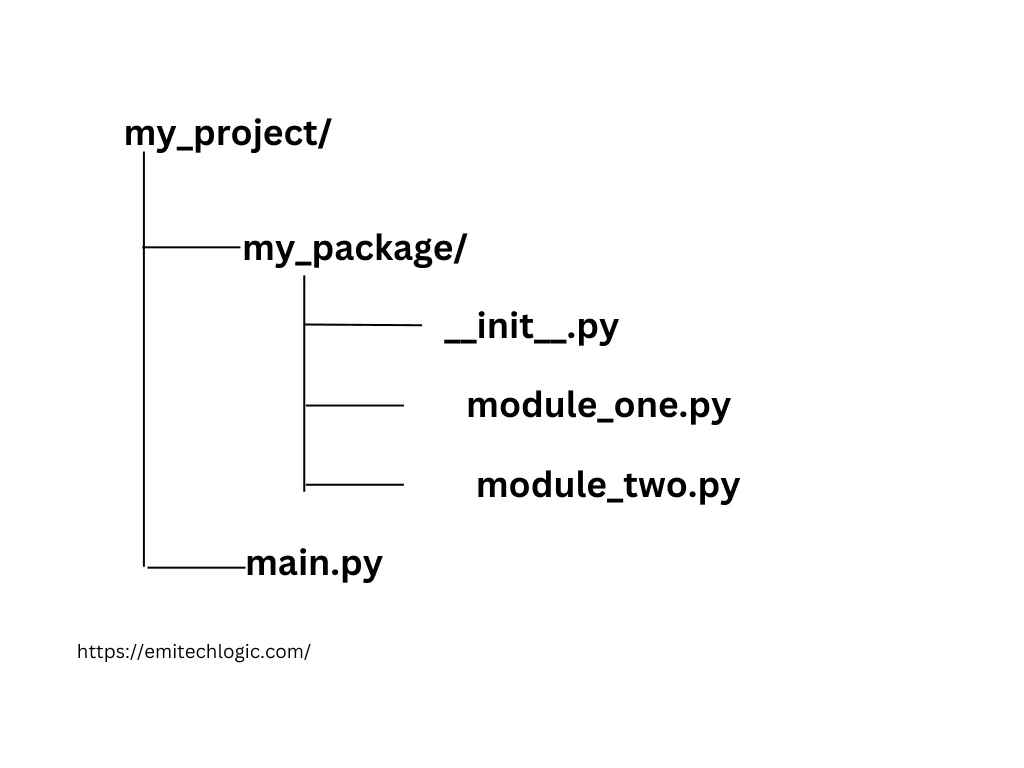
在 Python 工程实践中,明确模块(Module)与包(Package)的边界是构建可维护系统的基础。模块通常对应单个 .py 文件,而包则是包含多个模块的目录结构,且必须包含 __init__.py 文件以标识其为包。合理的目录分层不仅能避免命名空间污染,还能提升代码的可读性。例如,在一个名为 my_project 的项目中,main.py 作为入口文件,core 和 utils 作为功能子目录。在 core/__init__.py 中可留空或执行包级初始化逻辑。通过 import core.config 导入整个模块,或使用 from utils.helpers import format_date 精准提取特定函数,这种分层导入机制使得代码职责清晰,便于后续的工程化协作与维护。
隔离环境:虚拟环境配置与依赖管理
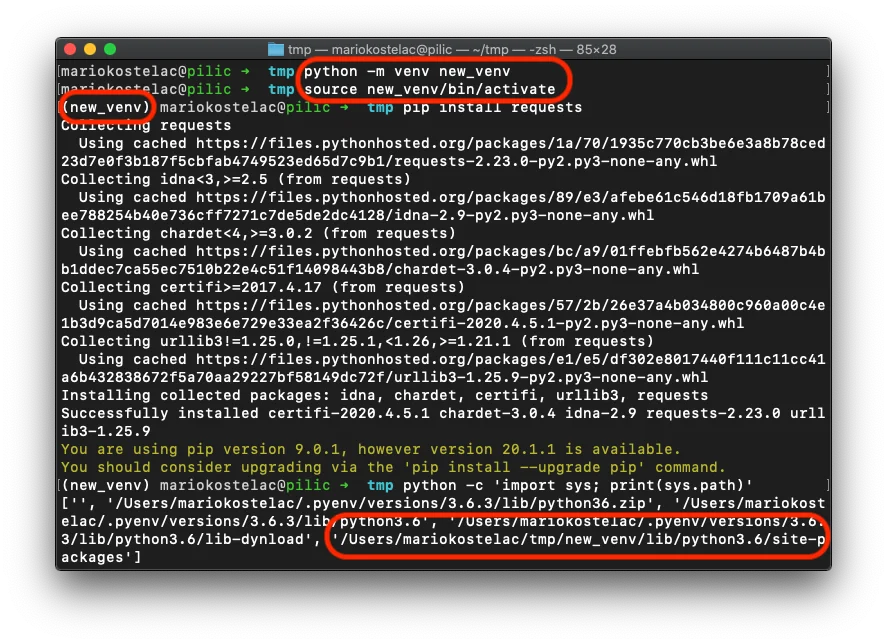
项目依赖的隔离是保障环境稳定性的核心。推荐使用 Python 内置的 venv 模块创建独立虚拟环境,避免全局包污染。执行 python -m venv .venv 生成隔离目录,随后通过 source .venv/bin/activate(Linux/macOS)或 .venv\Scripts\activate(Windows)激活环境。激活后,终端提示符会显示环境名称,此时使用 pip install requests==2.31.0 即可安装指定版本的第三方包。通过 pip list 可查看当前环境已安装包及其版本,pip install --upgrade requests 用于安全升级,pip uninstall requests 则用于清理废弃依赖。为便于团队协作与环境复现,应使用 pip freeze > requirements.txt 导出依赖清单。该文件记录了精确的版本号,其他开发者只需执行 pip install -r requirements.txt 即可一键还原完全一致的运行环境,彻底消除兼容性难题。
模块化案例:高内聚低耦合的代码组织
模块化设计的核心在于高内聚低耦合。以一个简易的文本统计工具为例,可将功能拆分为独立模块:在 utils/text_processor.py 中定义 count_words 函数,在 utils/file_handler.py 中实现 read_file 与 write_report。主程序 main.py 通过 from utils.text_processor import count_words 和 from utils.file_handler import read_file 按需导入。在 main.py 中,先调用 read_file 读取目标文件内容,再传入 count_words 计算词频,最后将结果格式化输出。若需扩展功能,只需在 utils 目录下新增模块,无需修改主程序逻辑。这种架构使代码职责单一,测试时可针对单个模块编写单元测试,部署时也可按需打包。通过清晰的导入路径与函数调用链,项目结构呈现出树状依赖关系,大幅降低了后期维护成本。
常见导入错误排查与依赖冲突解决
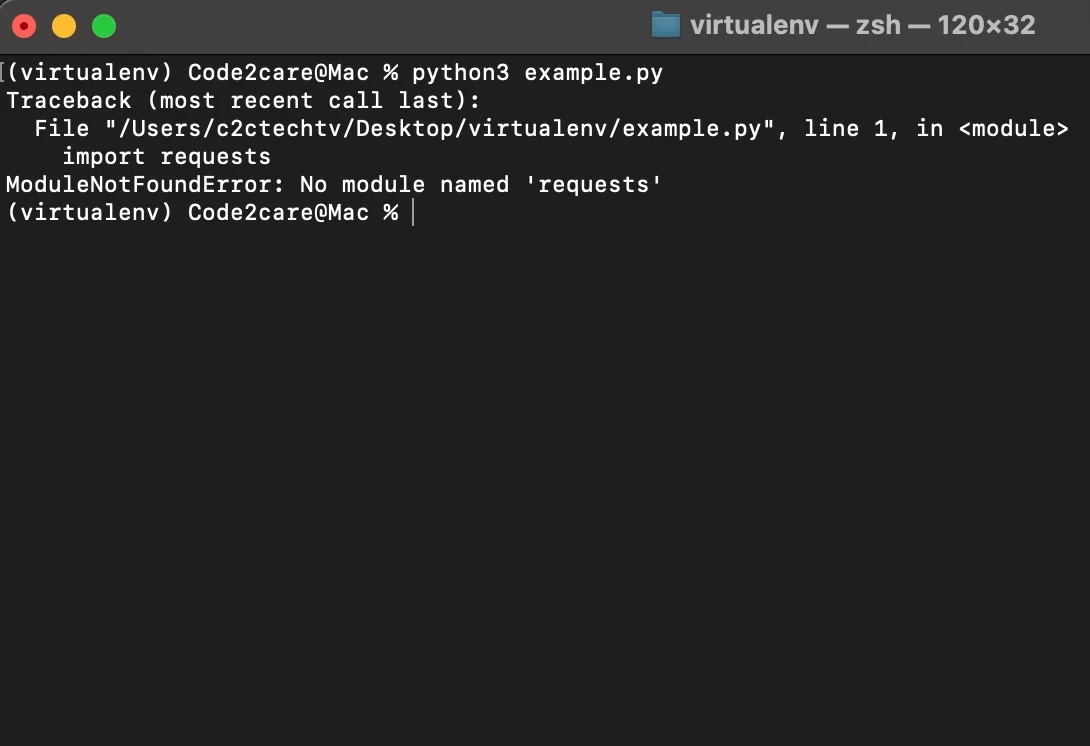
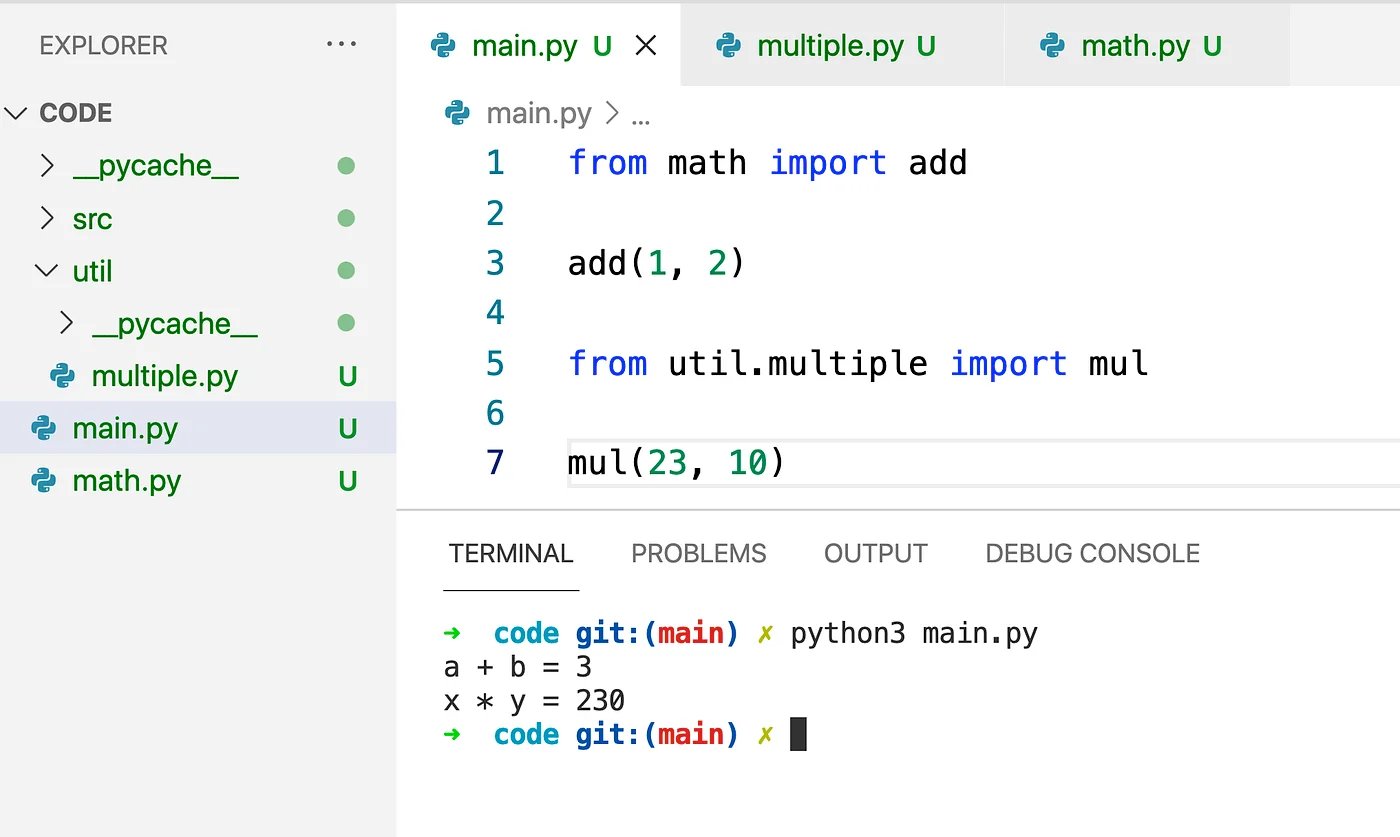
模块与包在实际运行中常因路径或依赖问题报错。遇到 ModuleNotFoundError 时,首先检查当前工作目录是否在 sys.path 中,可通过 import sys; print(sys.path) 验证;若包目录未被识别,可在入口文件顶部添加 sys.path.append(os.path.dirname(os.path.abspath(__file__))),或确保以包根目录为起点执行脚本。ImportError 多由拼写错误、缺失 __init__.py 或循环导入引起。循环导入指 A 模块导入 B,B 又导入 A,导致解释器陷入死锁,解决方法是将共享逻辑抽离至独立模块,或改用延迟导入。依赖版本冲突可通过 pip check 检测,若提示不兼容,需使用 pip install package==x.y.z 锁定兼容版本。排查时建议开启 python -v 查看导入详细过程,结合终端报错堆栈精准定位,确保模块调用链路畅通无阻。