





理解re.compile预编译与Pattern对象
在Python标准库re中,直接调用re.search()或re.match()时,解释器会在底层隐式执行正则表达式的解析与编译过程。若使用re.compile(pattern),则会显式生成一个Pattern对象,该对象将正则字符串转换为内部可执行的字节码或状态机。预编译的核心价值在于一次编译多次执行,当同一正则需要在不同文本或循环中反复使用时,显式编译能避免重复的语法分析与状态机构建开销。Pattern对象提供了与模块级函数同名的方法,如search()、match()、findall()、finditer()和sub(),调用时只需传入目标字符串即可。例如,定义pat = re.compile(r'\d{3}-\d{4}')后,可通过pat.search(text)直接获取匹配结果,代码结构更清晰且执行路径更短。
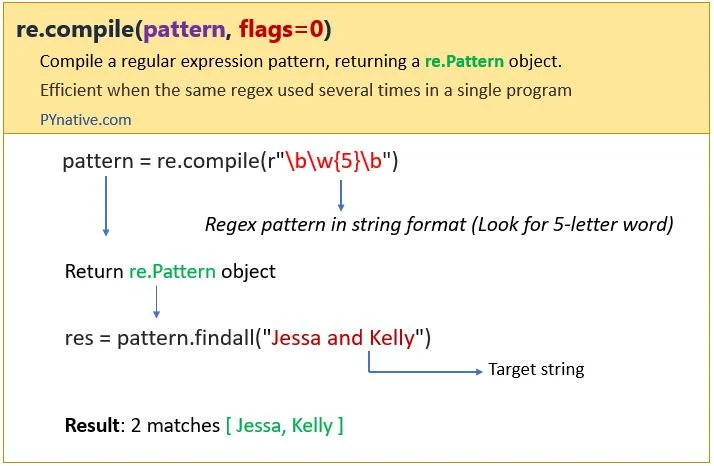
用re.compile优化重复正则匹配
在处理批量数据时,预编译的优化效果尤为显著。假设需要遍历包含大量日志的列表提取IP地址,若每次循环都调用re.search(r'\d+\.\d+\.\d+\.\d+', line),Python虽具备最近使用缓存机制,但在高频调用下仍会产生额外的字典查找与缓存替换开销。改为预编译模式后,可先执行ip_pattern = re.compile(r'\d+\.\d+\.\d+\.\d+'),随后在循环中仅调用ip_pattern.search(line)。这种写法将编译成本前置,循环体内仅保留纯粹的匹配逻辑。通过timeit模块进行基准测试可直观验证:在相同数据集与正则复杂度下,复用Pattern对象的执行耗时通常低于直接调用模块函数,尤其在正则表达式较长或包含复杂断言时,性能差距会进一步放大。开发者应优先在循环、回调函数或高频接口中采用此模式。
Flags、命名分组与Pattern复用实践
re.compile不仅是性能工具,更是正则配置与复用的最佳载体。通过其第二个参数可集中声明匹配标志,例如re.compile(r'^Error:\s*(?P

性能优化的边界与常见避坑
预编译并非万能银弹,其收益高度依赖使用场景。对于仅执行一次或极少调用的正则匹配,直接使用re.search()更为简洁,Python内置的LRU缓存已能妥善处理低频请求,强行预编译反而增加代码冗余。真正的性能瓶颈往往源于正则表达式本身的设计缺陷,而非编译方式。例如,使用(.*)+或嵌套量词处理长文本时,极易触发灾难性回溯,导致CPU占用飙升甚至进程假死。此时优化重点应转向精简模式、使用非贪婪匹配、原子分组或拆分复杂逻辑。开发者应避免为了预编译而预编译,在编写正则时优先保证逻辑正确与回溯安全,仅在确认存在高频重复调用且正则复杂度较高时,再引入re.compile进行针对性优化。







