




杨植麟与Kimi复刻DeepSeek旧剧本

KimiK3模型引发硅谷恐慌,被类比为“DeepSeek2 0时刻”。恐慌源于开源扩散效应、AI基建泡沫及中美模型代际差缩短。Kimi与DeepSeek在技术联动、不竞争战略及扁平组织上相似,但Kimi尚未成为共识,面临成本控制与国产算力适配挑战。
DeepSeek是共识,但Kimi还不是
Kimi和杨植麟,正在拿到DeepSeek的「国运剧本」。
先是Kimi K3引发的硅谷恐慌——Anthropic CEO在美国国会AI安全听证会上公开表示“K3蒸馏了其模型”;紧接着外媒开始集中报道Kimi创始人杨植麟“拒绝苹果谷歌邀约、坚持回国创业”的故事……
外媒《商业内幕》这样形容:Kimi K3模型发布后,谷歌和英伟达等美国大型科技股遭到抛售,这让人想起去年中国人工智能初创公司DeepSeek引发的市场震荡。
有媒体干脆用“DeepSeek 2.0时刻”来形容Kimi,甚至杨植麟本人还登上了微博热搜——“90后清华天才干崩了美股”。短视频平台上,他清华答辩的视频也意外出圈了。
紧随而来的是月之暗面的上市消息。据报道,月之暗面计划于8月启动上市前最后一轮融资谈判,目标估值为投前500亿美元,比上一轮又多了200多亿。
曾经向媒体形容“向延绵而未知的雪山前进”的月之暗面和杨植麟,现在正朝着亦敌亦友的DeepSeek亦步亦趋。
1、K3恐慌为何形成?
理解硅谷自上而下对Kimi K3的恐慌,先要理解,他们到底在恐慌什么?
第一,恐惧的是开源扩散效应。
Kimi K3争夺的从来都不是“模型更聪明”的心智,而是“我的开源模型能力比你的闭源模型强”。
这和2025年DeepSeek引发硅谷恐慌的逻辑相似——中国模型厂商正通过开源策略,将自身在底层算力、技术架构、资金供给等方面的短板,转化为一种系统化的优势。
而开源模型的扩散效应会直接利好两方面:
一方面,最直接的就是增强自己在企业、开发者和普通用户间的存在感,加速基础模型的商品化。面对Kimi K3,企业和开发者都会直接评估:是继续用OpenAI、Anthropic的模型,还是用来自中国的开源模型。
另一方面,扩充生态。开源模型本身就是模型厂商加速智能能力进入生产生活的重要策略。Kimi K3会迅速吸引上下游生态的聚合,从底层算力芯片到中游模型再到下游端侧和软件侧,都会因开源形成研发和落地的协同效应。
第二,硅谷对Kimi K3的恐慌,也是这几年来“AI泡沫论”的延续。
谷歌、微软、亚马逊和Meta四家公司,2026年的资本支出合计预计高达7250亿美元,到2027年将进一步攀升至近9000亿美元,4家巨头合计每天就烧掉20亿美元。
天价AI基建投入,尚未收获规模化的回报,但大幅上升的资本支出已经开始挤压自由现金流。
华尔街对巨头“修改折旧周期来增加利润”的方式,也开始不满。知名空头、Chanos & Co.创始人Jim Chanos在播客里吐槽:没人能算得清数据中心的账。
“大量购入但尚未投入使用的GPU和数据中心设备,都被记录在资产负债表的‘在建工程’里,折旧计提尚未开始。”
华尔街担心的不是Kimi K3,而是一旦中国开源模型所代表的免费AI加速渗透,将会进一步影响云厂商和模型厂商的算力投入回报率。
第三,恐惧中美大模型能力代际差的缩短。
一个共识是,在一些传统基准测试上,中国模型过去追赶海外模型“御三家”的时间大约是6到9个月。但随着中国模型厂商发布速度的提升,这个速度差正在被缩小。

用更快的发布速度,在真实使用里缩短性能差距——美国AI研究者Nathan Lambert在近期接受采访时,认为这是一种中国策略。
他提到,相比榜单上的评分,在用户的真实使用里,不同模型的能力差距其实非常接近。而中国发布得更快,相当于把用户实际拿到的性能差距给缩小了,同时还能根据用户反馈率先改进。
2、拿到DeepSeek剧本的,为什么是Kimi?
在今天大模型行业的竞争里,“DeepSeek效应”已经被滥用成了一个形容词。
对国内模型厂商而言,DeepSeek无疑是令人艳羡的。一方面,它为中国模型提供了一个看得见的方向:通过开源卡位模型心智,利用模型架构创新和工程化能力降低训练、推理成本。另一方面,DeepSeek自身的独特性——量化出身、创始人的克制以及扁平的组织架构,都放大了外界对这家中国模型的期待。
随着Kimi K3发布,Kimi和杨植麟一定程度上确实拿到了类似DeepSeek的剧本。比如海外模型厂商的担忧、开发者的好评以及随之而来的算力不足问题,甚至杨植麟本人登上热搜,这也是他第一次在大众意义上的出圈。
那么,为什么是Kimi?
第一,两家公司技术层面的联动。
两家公司的模型发布不仅多次撞车,甚至技术层面也有默契。Kimi K2采用了DeepSeek V3的MLA注意力机制,DeepSeek V4则引入了Kimi大规模验证的Muon优化器。
在Kimi K2模型时,《自然》杂志就已经用“又一个DeepSeek时刻”来形容。
甚至在表明技术追赶上的态度时,两家公司都用了相似意义的古文:
Kimi在《Kimi K3:智能的新前沿》中提到:“犯其至难而图其至远者,发之以勇,守之以专,达之以强。”这句话的典故出自苏轼所作的《思治论》。Kimi想表达的是,追求AGI很难,但实现这个最远大的目标,就需要靠勇气、专注和强大执行力。
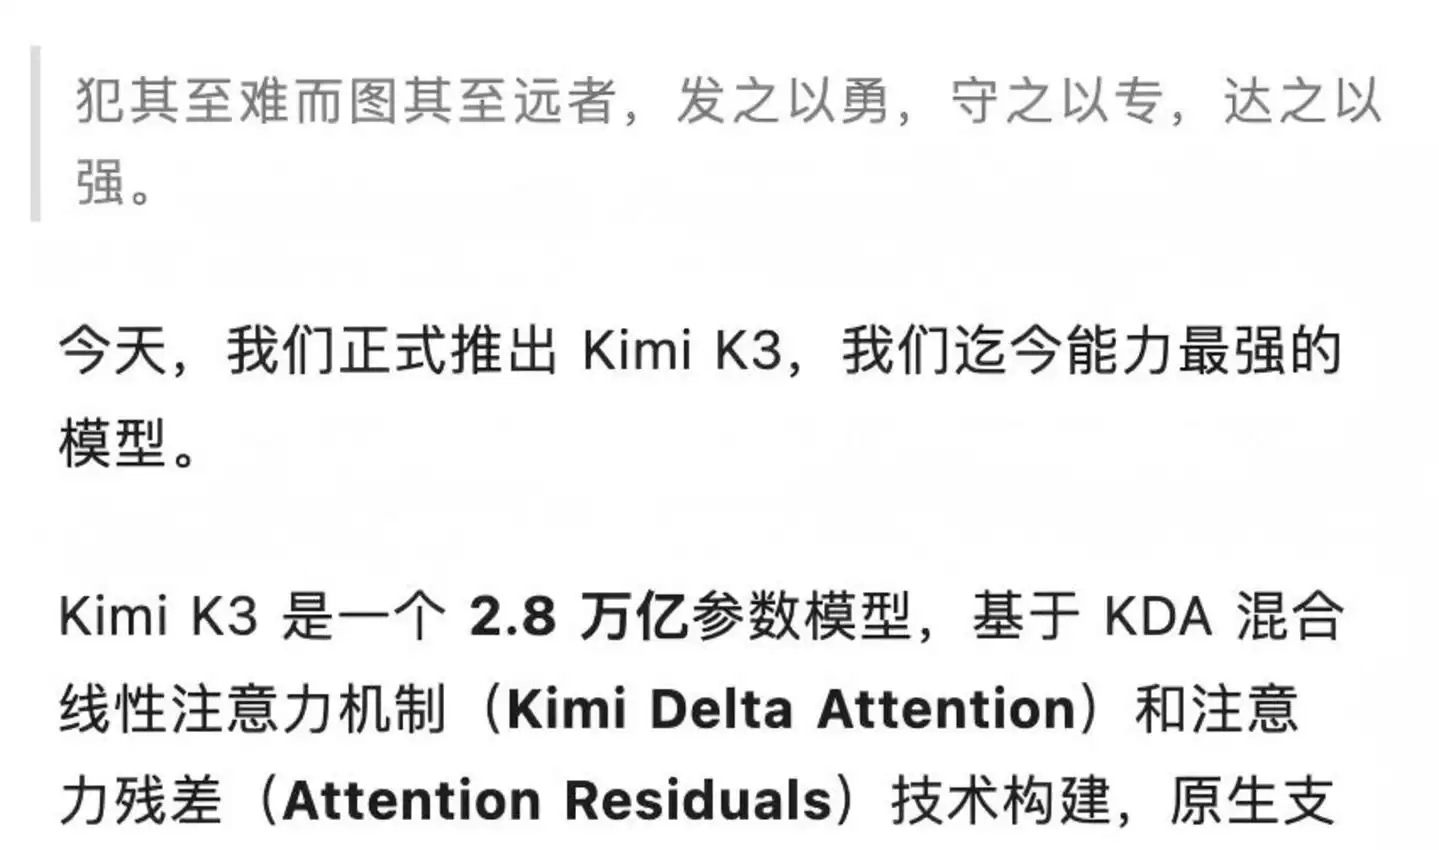
DeepSeek在DeepSeek-V4的发布稿中则引用了荀子的名言:“不诱于誉,不恐于诽,率道而行,端然正己”,用来形容对自身目标的坚守。
第二,两家公司商业战略上的共性。
在梁文锋4小时的闭门会里,他提到了对竞争的态度:“我也不担心别人部署我们的模型,然后跟我们来竞争,一点都不担心。我们还希望他们能够部署起来。”
Kimi总裁张予彤在去年被问到“如何在技术和市场层面与巨头大厂形成差异化定位”时,也提到了类似的看法。她说:“最有效的竞争方式就是‘不竞争’。不竞争不是躺平,而是要找到自己的叙事,找到自己真正擅长的事情。”
在基模创业型公司里,DeepSeek和Kimi都是有着独特生态位的独角兽。DeepSeek的克制和开源,Kimi所强调的克制和审美——它不做生活娱乐方向、不做多模态生成。
第三,是年轻扁平化的组织架构。
美国AI研究者Nathan Lambert在走访中国模型公司和大厂后提到,Kimi是他拜访过的这批中国公司里“氛围最好”的一家。“你会感觉这群人关系特别近,做出一个很酷的东西本身就让他们兴奋,并且还能把它商业化。那种紧密感,是你一走进办公室就能直观感受到的。”
同样的,DeepSeek的团队也没有科层制的大公司化。据《晚点》报道,DeepSeek团队界限形成了“交叉分工”,梁文锋的角色更像是一位实验室的导师。
三点相似性让DeepSeek和Kimi反复被拿来比较,因此这次拿到与DeepSeek相似的剧本也并不意外。
3、DeepSeek是共识,但Kimi还不是
但手拿DeepSeek的剧本,并不代表Kimi能活成DeepSeek。
一位AI投资人向媒体形容:“DeepSeek可能是现在AI模型里最大的共识,但Kimi还不是。”
他给出原因有两点:第一,DeepSeek和梁文锋都有很强的成本意识,包括API定价、算力储备,以及被传出自研芯片计划。第二,国产化的决心,梁文锋本人看好国产算力生态。
但现阶段的Kimi,尚且不能准确回应这两大挑战。
首先,开源所带来的成本投入和克制商业化战略下的盈亏平衡。
Kimi尽管此前公布了收入曲线——3亿美元ARR、API贡献七成、海外付费用户同比增长400%、产品落地200多个国家,但它并没有实现Token的经济性。
据第三方机构Artificial Analysis的测算,Kimi K3单任务成本约0.94美元,与GPT-5.6 Sol的1.04美元接近,约为Claude Opus 4.8(1.80美元)的一半,价格带基本和海外头部模型属于同一阵营。
更关键的是,模型单价只是第一层成本账。一位开发者告诉媒体,真实业务开发环境里实际Token消耗得更快,如果没有明显的价格优势,只是平替,Kimi K3只是提供了一个新选择,而不是必选项。
其次,与国产算力生态的深度适配。
尽管在世界人工智能大会期间,月之暗面曾披露已同步适配包括华&为昇腾在内的国产芯片,但还是落后于DeepSeek、智谱等模型厂商的多元化动作。
在Kimi找算力之时,据彭博社报道,智谱已建成一座全部采用国产芯片的大型数据中心,并开始部分运行。不久前,智谱还买下了一家国产AI基础设施企业中科加禾。
杨植麟曾说过Kimi对他讲的一句话:“任何中间状态都有可能成为被批评的对象。你总是会有这个时代的局限性。”
对月之暗面来说,它仍处于这样的中间状态。想要实现更高的智能,它的前面还站着更多的DeepSeek。
参考资料:
1、美国AI研究员的中国之旅:年轻人,追赶者,算力焦虑与“AGI展示厅” |专访Nathan Lambert
2、语言即世界:和杨植麟时隔一年的独家对话:“站在无限的开端”

游乐网为非赢利性网站,所展示的游戏/软件/文章内容均来自于互联网或第三方用户上传分享,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系youleyoucom@outlook.com。
 同类文章

CAD零基础入门教程:坐标输入、图层管理与基础绘图命令
本文面向CAD零基础学习者,系统讲解坐标输入、图层管理与基础绘图命令的核心用法。通过分步实操与常见问题排查,帮助新手建立精确绘图习惯,掌握规范出图的基础能力。

CAD从入门到项目交付:绘图、标注、图块与实战工作流
掌握CAD的核心在于建立“画得准、标得清、复用快、交付稳”的工作流。本文提供从环境设置、高频命令组合、标注规范、图块标准化到项目分阶段交付的完整路径,帮助初学者避免常见返工陷阱,独立完成可检查、可复用、可打印的工程图纸。

Claude Code 登录指南:个人、Teams 与企业账号区分与授权步骤
本文详细解析 Claude Code 登录前的账号类型区分方法,涵盖个人订阅、Teams 席位与企业 Enterprise 席位的授权路径差异。提供终端登录命令、环境变量排查及常见异常处理步骤,帮助用户快速完成正确授权并避免登录路径混淆。

Claude Code 文件修改前的权限模式配置与命令审批指南
本文详细介绍Claude Code在修改文件前的权限模式配置方法,包括defaultMode可选值、permissions allow与deny规则设置、多层级配置文件管理以及 status验证技巧,帮助开发者安全高效地使用AI编程助手。

Claude Code接入VS Code后先测扩展和终端命令
在VS Code中接入Claude Code后,建议优先验证扩展面板与集成终端两条入口。本文提供标准检查顺序、关键命令与常见故障排查路径,帮助你快速确认环境就绪,避免后续开发受阻。


- 热门数据榜
 1
 2
 3
 4
5
6
7
8
9
10
相关攻略
 2026-09-01 16:53
2026-09-01 16:52
2026-09-01 14:27
2026-09-01 14:12
2026-09-01 14:10
2026-09-01 14:07
2026-09-01 13:55
2026-09-01 13:47
热门教程
- 游戏攻略
- 安卓教程
- 苹果教程
- 电脑教程







