




谷歌发布Gemma 4 QAT:1GB内存运行大模型,端侧AI再进一步

最近,许多开发者都在关注一个核心问题:尽管当前开源模型层出不穷,但真正限制本地部署的主要瓶颈并非算力,而是内存。即便是7B级别的量化模型,运行起来往往也需要数个GB甚至十几GB的显存或内存。 就在近期,谷歌正式推出了Gemma 4 QAT(量化感知训练)版本,在端侧部署能力上实现了显著突破。其中,最
最近,许多开发者都在关注一个核心问题:尽管当前开源模型层出不穷,但真正限制本地部署的主要瓶颈并非算力,而是内存。即便是7B级别的量化模型,运行起来往往也需要数个GB甚至十几GB的显存或内存。
就在近期,谷歌正式推出了Gemma 4 QAT(量化感知训练)版本,在端侧部署能力上实现了显著突破。其中,最引人注目的数据是:Gemma 4 E2B模型的内存占用已降至1GB以下。
这意味着,在手机、轻薄本和嵌入式设备上流畅运行高质量AI模型的愿景,正变得日益现实。
什么是Gemma 4 QAT?
根据谷歌官方的说明,与传统量化方案相比,QAT的核心区别在于量化的执行时机。
| 方案 | 全称 | 量化时机 |
|---|---|---|
| PTQ | 训练后量化(Post Training Quantization) | 模型训练完成后进行量化 |
| QAT | 量化感知训练(Quantization Aware Training) | 在模型训练过程中模拟并执行量化 |
传统的PTQ流程如下:
训练模型 → 导出权重 → 量化压缩 → 部署
而QAT的流程则是:
训练模型 → 在训练阶段模拟量化误差 → 模型学习并适应量化影响 → 部署
关键区别在于,由于模型在训练阶段就已提前适应量化带来的精度损失,因此最终的压缩效果通常更为出色。
为什么QAT优于传统PTQ?
许多开发者在本地部署模型时,可能都遇到过类似情况:FP16版本的模型表现优异,但量化到4bit后,回答质量会明显下降。
原因并不复杂:量化本质上是以损失部分权重精度为代价。例如,原始权重为0.3521、0.4824、0.1948,量化后变为0.35、0.48、0.19。单看每个参数的误差似乎很小,但这是数十亿个参数误差的累积效果。最终结果就是:推理质量下滑、逻辑能力减弱、代码生成能力下降以及幻觉现象增多。
QAT的做法是:在训练阶段就主动引入这些量化误差,让模型在训练过程中“预先学习”量化后的数据表现。这样一来,部署时的误差变得可控,最终实现的结果是:更高的压缩率、更低的运行内存占用以及更少的性能损失。这已成为当前高质量量化模型的主流发展方向。
Gemma 4本次实现了哪些核心优化?
谷歌此次针对移动设备进行了专门设计,主要包含四项关键优化。
V1:静态激活
传统方案需要在运行时计算缩放因子,这会增加CPU负载并延长推理延迟。Gemma 4 QAT的做法是:在训练阶段就预先确定缩放参数。其优势非常明显——响应速度更快、功耗更低,更适合移动端设备。
V2:通道量化
传统量化是对整个张量进行统一量化,容易导致部分通道误差过大。而Gemma 4采用了对每个通道独立量化的方式,每个通道都拥有独立的缩放因子。这使得精度损失更小,同时更好地适配移动端NPU,推理效率自然显著提升。
V3:针对性的2-bit量化
这是此次更新中颇具亮点的一项技术。谷歌并未简单粗暴地将所有内容都压缩到最低,而是采取了更为精细的策略:关键层保留较高精度,非关键层则压缩至2-bit。本质上是一种4-bit与2-bit的混合量化方案。这种思路类似于现代视频编码——重点区域使用高码率,背景区域使用低码率,将计算资源投入到最重要的地方。
V4:Embedding与KV Cache优化
大模型运行时,KV Cache是内存消耗的大头之一,它负责存储上下文信息。上下文越长,KV Cache的占用就越大。谷歌对Embedding、Vocabulary和KV Cache均进行了压缩优化。优化后,模型能支持更长的上下文,同时内存占用更少,OOM(内存溢出)风险也显著降低。对于移动端而言,这一点尤为重要。
E2B模型内存占用降至1GB以内
此次最受关注的数据是:Gemma 4 E2B模型的内存占用已低于1GB。
通过一个简单的对比即可清晰了解:
| 模型版本 | 内存需求 |
|---|---|
| 7B FP16 | 14GB以上 |
| 7B Q4 | 约4GB |
| 3B Q4 | 约2GB |
| Gemma 4 E2B QAT | 低于1GB |
简而言之,手机、平板、轻薄笔记本甚至单板计算机,如今都具备了运行此类模型的空间。端侧AI的应用场景,无疑将因此得到显著扩展。
官方内存优化对比
从这张对比图中可以清晰地看到:E2B模型的内存占用大幅降低,E4B模型也得到了进一步优化,多种部署模式均实现了显著改善。这无疑是QAT训练价值最直接的体现。
支持哪些部署方式?
谷歌此次在生态支持方面做得非常全面,覆盖了主流的部署方案。
- Hugging Face:可直接下载Q4_0 Mobile QAT模型权重。
- llama.cpp:支持GGUF格式,适用于Windows、Linux、Mac的本地运行。
- Ollama:可直接部署,命令为
ollama run gemma4,适合普通开发者快速体验。 - LM Studio:提供图形化界面部署,无需命令行操作。
- vLLM:适用于服务端部署,支持高并发、高吞吐量的API服务。
- SGLang:目前热门的推理框架之一,适合Agent推理优化及企业级部署。
- MLX:专为Apple Silicon优化,支持从M1到M4系列芯片。
- Transformers.js:支持在浏览器中直接运行,例如通过
import { pipeline } from "@xenova/transformers";实现。未来创建网页端离线AI应用将变得更加便捷。
官方硬件需求图
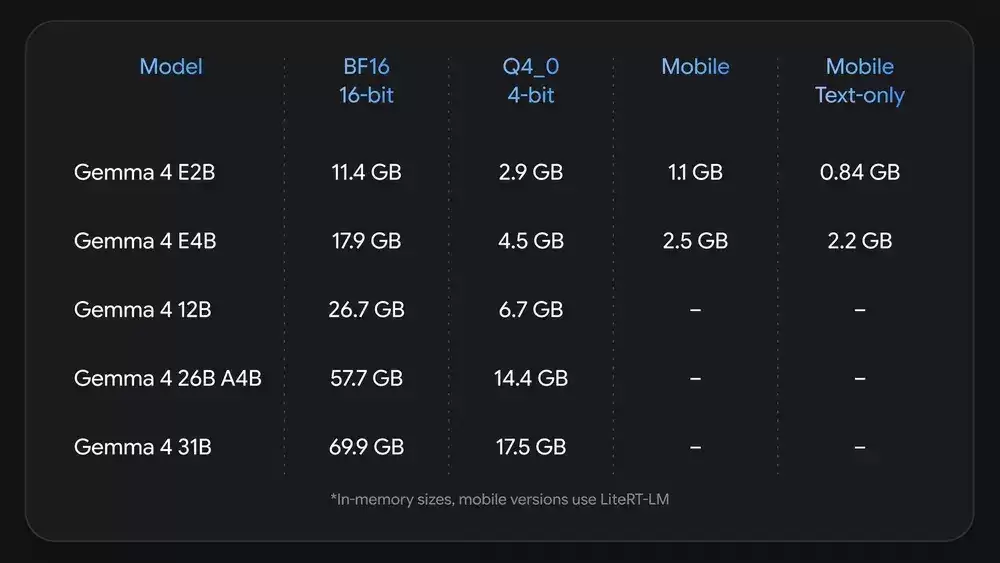
根据官方公布的硬件需求,无论是CPU、GPU、NPU还是Apple Silicon,都能获得良好的运行体验。不同平台均有对应的优化版本可供选择。
MTP能力依然保留
除了量化优化,谷歌还特别强调:Multi-Token Prediction(MTP)在量化后依然可用。传统模型一次只生成一个Token,而MTP可一次预测多个Token。其优势在于提升生成速度并降低延迟。在聊天场景中,这意味着首字响应更快,整体输出也更加流畅。
总结
从技术路线来看,谷歌此次的重点不在于继续扩大模型参数规模,而是聚焦于一个更实际的问题:如何让大型模型在端侧设备上高效运行。
当前AI行业的发展已呈现出清晰的趋势:第一阶段是比拼参数规模,如70B、405B、671B;第二阶段则是比拼推理效率,涉及量化、蒸馏、MoE和KV Cache优化;而第三阶段正是端侧AI,覆盖手机、AIPC、浏览器AI及离线AI等领域。Gemma 4 QAT显然是第三阶段的重要产品。
这些特性意味着,未来大量AI应用可能不再依赖云端推理,而是直接在本地完成。对于开发者而言,本地AI助手、浏览器AI插件、移动应用、Edge AI设备以及AI硬件产品,都将迎来更低的接入门槛。
| 关键特性 | 核心优势 |
|---|---|
| QAT量化感知训练 | 有效减少量化带来的精度损失 |
| 静态激活 | 显著降低移动端的计算开销 |
| 通道量化 | 进一步提升模型推理效率 |
| 2-bit针对性压缩 | 进一步减小模型整体体积 |
| KV Cache优化 | 有效减少运行时的内存占用 |
| E2B模型 | 内存占用成功控制在1GB以下 |
| MTP支持 | 显著提高文本生成速度 |
| 多平台生态支持 | 全面覆盖Ollama、LM Studio、vLLM、MLX、Transformers.js等主流框架 |
随着Gemma 4 QAT的发布,大模型正从“云端专属”逐步走向“人人皆可本地部署”。对于开发者和AI应用创业者而言,这类低内存、高性能的模型,有望成为未来端侧AI生态的重要基础。

游乐网为非赢利性网站,所展示的游戏/软件/文章内容均来自于互联网或第三方用户上传分享,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系youleyoucom@outlook.com。
 同类文章

CAD零基础入门教程:坐标输入、图层管理与基础绘图命令
本文面向CAD零基础学习者,系统讲解坐标输入、图层管理与基础绘图命令的核心用法。通过分步实操与常见问题排查,帮助新手建立精确绘图习惯,掌握规范出图的基础能力。

CAD从入门到项目交付:绘图、标注、图块与实战工作流
掌握CAD的核心在于建立“画得准、标得清、复用快、交付稳”的工作流。本文提供从环境设置、高频命令组合、标注规范、图块标准化到项目分阶段交付的完整路径,帮助初学者避免常见返工陷阱,独立完成可检查、可复用、可打印的工程图纸。

Claude Code 登录指南:个人、Teams 与企业账号区分与授权步骤
本文详细解析 Claude Code 登录前的账号类型区分方法,涵盖个人订阅、Teams 席位与企业 Enterprise 席位的授权路径差异。提供终端登录命令、环境变量排查及常见异常处理步骤,帮助用户快速完成正确授权并避免登录路径混淆。

Claude Code 文件修改前的权限模式配置与命令审批指南
本文详细介绍Claude Code在修改文件前的权限模式配置方法,包括defaultMode可选值、permissions allow与deny规则设置、多层级配置文件管理以及 status验证技巧,帮助开发者安全高效地使用AI编程助手。

Claude Code接入VS Code后先测扩展和终端命令
在VS Code中接入Claude Code后,建议优先验证扩展面板与集成终端两条入口。本文提供标准检查顺序、关键命令与常见故障排查路径,帮助你快速确认环境就绪,避免后续开发受阻。


- 热门数据榜
 1
 2
 3
 4
5
6
7
8
9
10
相关攻略
 2026-09-01 16:53
2026-09-01 16:52
2026-09-01 14:27
2026-09-01 14:12
2026-09-01 14:10
2026-09-01 14:07
2026-09-01 13:55
2026-09-01 13:47
热门教程
- 游戏攻略
- 安卓教程
- 苹果教程
- 电脑教程







