





第一步:用 Schema 锁定输出契约
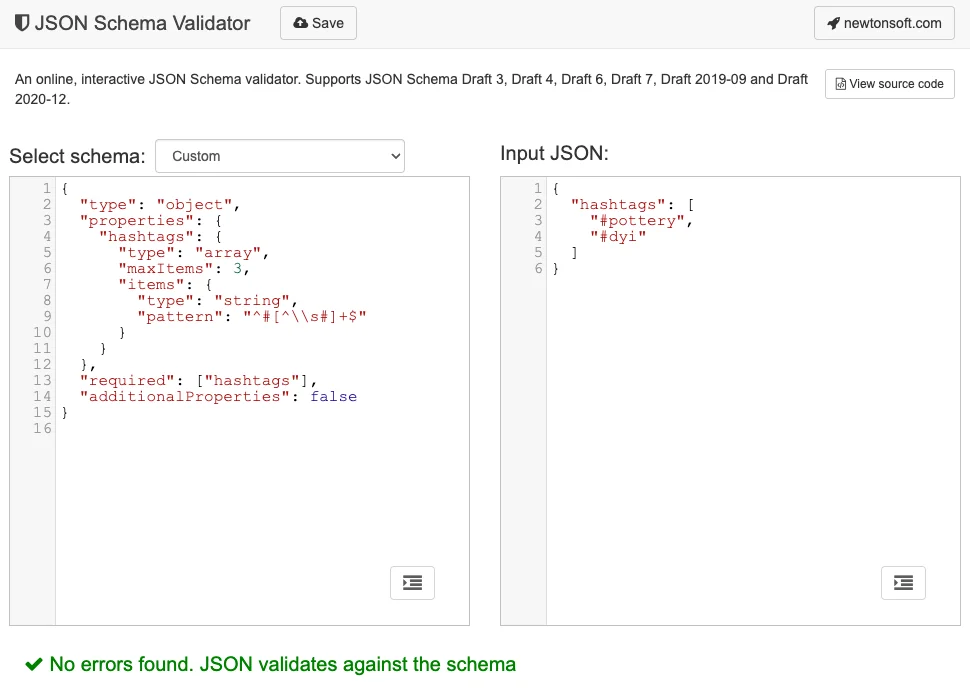
稳定输出的前提是明确的契约。与其在提示词中用自然语言描述“返回用户信息”,不如直接使用 JSON Schema 定义数据结构。Schema 明确了字段类型(string、integer)、必填项(required)、枚举值(enum)以及嵌套层级。例如,定义一个用户对象时,明确 age 为大于 0 的整数,role 限定为 admin 或 user,并强制要求 id 和 name 存在。这种契约化设计为模型提供了清晰的填空框架,大幅降低字段缺失或类型错乱(如数字变字符串)的概率,确保下游系统能按预期解析。

利用原生能力强制约束生成
仅靠提示词约束往往不够,必须结合大模型原生的结构化输出能力。主流平台提供的 response_format 或 tool_use 机制,能在底层解码阶段强制模型遵循 Schema 规则。对于支持 Structured Outputs 的模型,开启 strict 模式可彻底拦截非法字段与类型偏差;若使用函数调用,则需将参数定义映射为 JSON Schema。关键配置包括:关闭自由文本生成、设置较低的 temperature(建议 0.1 至 0.3)以及明确指定输出格式参数。简单键值对可用基础 JSON 模式,复杂业务逻辑则推荐函数调用或工具定义,从而在推理源头实现硬性约束。

构建解析、验证与自动修复链路
模型输出后需建立完整的解析与验证链路。首先使用标准 JSON 解析器捕获语法错误;随后通过校验库对照预定义 Schema 进行字段完整性与类型检查。若校验失败,不应直接丢弃,而应触发自动修复机制:例如利用正则表达式剥离首尾非 JSON 字符,或调用轻量级修复 Prompt 让模型自我纠正。对于关键业务,可设置降级策略,如返回默认空对象或缓存历史有效数据。完整链路应包含原始输出捕获、语法清洗、Schema 强校验、失败重试(最多两次)与降级兜底,确保数据流不断裂且可追溯。
常见格式陷阱与稳定性避坑
实际应用中常遇多种格式陷阱。模型常将 JSON 包裹在 Markdown 代码块中,需通过正则或字符串切片剥离;附加解释性文字会破坏纯 JSON 结构,应在提示词末尾强调仅输出 JSON 且禁止任何额外说明。截断问题多因最大令牌数设置过小,需根据 Schema 预估长度并预留余量。字段漂移可通过严格 Schema 与大小写锁定规避。嵌套层级过深易引发括号不匹配,建议扁平化设计或限制最大深度。超长输出会导致解析超时,应拆分任务或启用流式校验。针对空值与缺失字段,需在 Schema 中定义默认值或明确允许空值,并在代码层做防御性判空。

上线前的自动化验证与监控体系
上线前必须构建自动化验证体系。首先收集覆盖常规、边界与异常场景的测试样本集,通过持续集成流水线自动运行 Schema 校验脚本,统计通过率与字段覆盖率。引入失败率监控面板,实时追踪解析异常、类型不匹配与重试次数,设置阈值告警。Schema 应实施版本化管理,任何字段增删需同步更新校验规则并回归测试。生产环境落地检查清单包括:核心接口强制开启严格模式、部署解析中间件并记录原始响应日志、配置熔断与降级开关、定期抽样人工复核模型输出质量。通过测试驱动与持续监控,确保 JSON 输出在迭代中保持高可用。







