

当前位置: 首页
编程语言
用 pytest-benchmark 建立可复现的性能基线:从对比到回归

用 pytest-benchmark 建立可复现的性能基线:从对比到回归

时间:2026-10-09
转载

本文介绍如何利用 pytest-benchmark 为 Python 代码建立可重复的性能基准,通过基准测试、对比分析和结果验证定位性能差异,同时避免测试环境、数据规模和统计方式带来的误判。

安装 pytest-benchmark 并建立基础基准测试

首先通过 pip install pytest pytest-benchmark 安装依赖。在项目中创建 test_perf.py,引入 benchmark fixture 即可快速建立最小可运行基准。例如,针对一个计算斐波那契数列的函数 fib(n),可编写测试用例 def test_fib(benchmark): benchmark(fib, 30)。benchmark 会自动接管执行流程,包含预热阶段、自适应迭代次数计算与多轮重复运行,无需手动编写循环。测试时需在终端执行 pytest --benchmark-only,框架将自动过滤非基准测试并输出耗时统计。明确测试对象为纯计算函数,输入数据固定为整数30,重复执行由框架根据统计显著性动态决定,确保基准具备可重复性与最小侵入性。在实际工程中,建议将待测函数与测试用例分离,并通过参数化传入不同规模输入,从而构建标准化的性能测量入口。
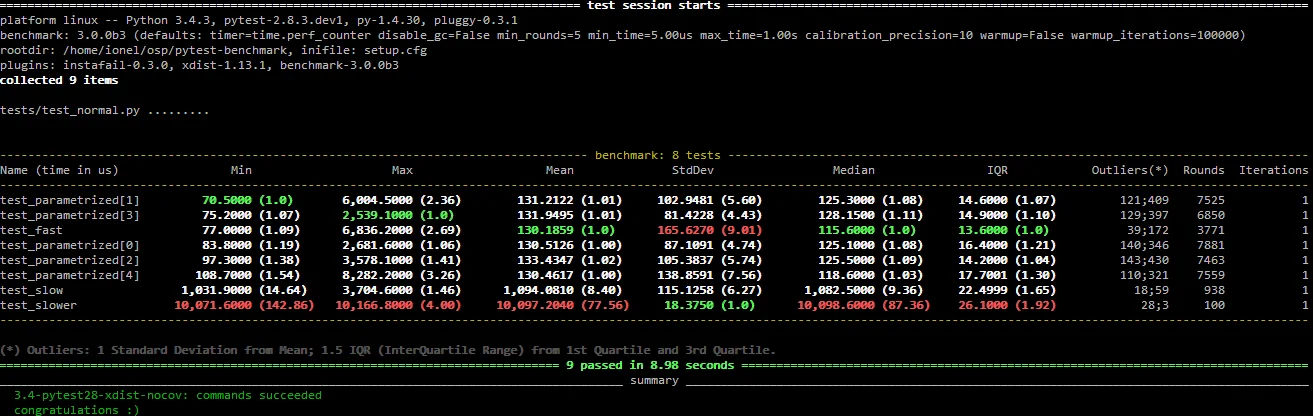
展示真实Python项目中的pytest测试文件、benchmark fixture代码以及终端执行pytest基准测试的结果。
pytest-benchmark基础测试运行结果,展示benchmark fixture及完整性能统计表。

设计公平的对比测试与控制测试变量

设计对比测试时,必须确保多个实现共享完全一致的输入数据与执行上下文。可通过 @pytest.fixture 预生成固定规模的数据集,并在所有对比用例中复用,避免数据生成耗时干扰测量。例如对比 "".join() 与 += 拼接字符串时,需使用相同长度与内容的字符串列表。同时应控制环境变量,如关闭操作系统的CPU动态调频(Linux下使用 cpupower frequency-set -g performance),清理后台高负载进程,并统一设置 pytest --benchmark-warmup=on --benchmark-min-rounds=5 以消除冷启动与缓存差异。若测试条件不一致,如一次使用小数据另一次使用大数据,或一次在空闲系统一次在编译后台运行,基准结果将产生严重偏差,导致错误优化方向。
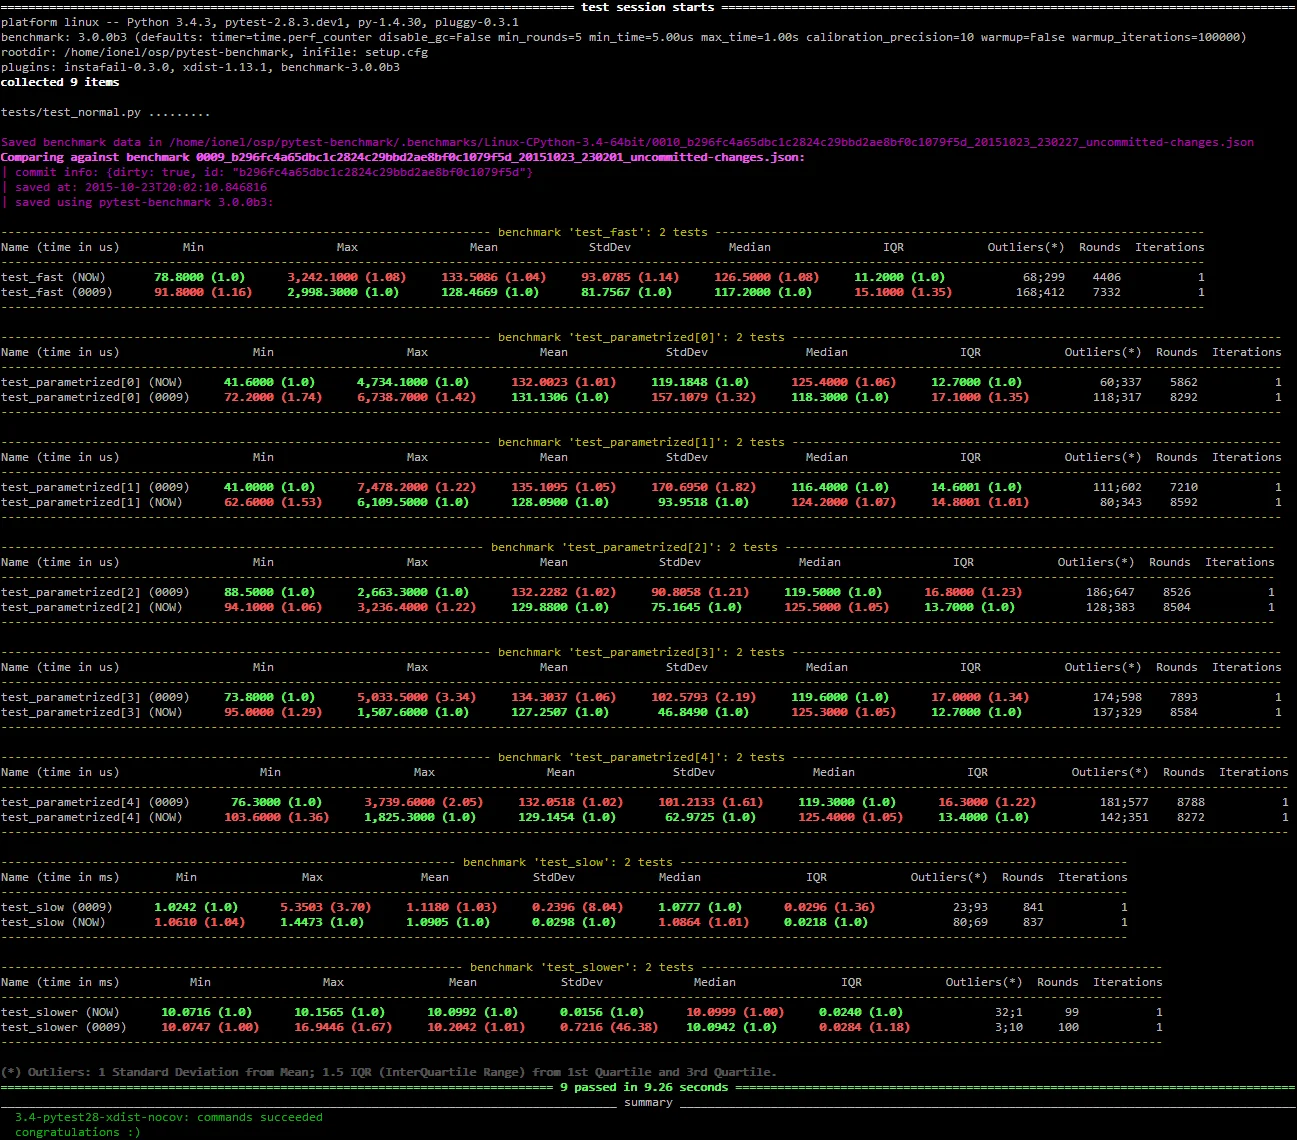
展示真实pytest-benchmark对比测试代码或终端结果,突出多个实现使用相同测试数据和benchmark参数进行性能比较。
pytest-benchmark对比模式的真实终端结果,可观察不同测试实现的性能差异。

读取基准结果并判断真实性能差异

执行结束后,终端会输出包含 min、max、mean、median、stddev 与 rounds 的统计表格。min 与 max 反映耗时边界,mean 为算术平均,median 为中位数,stddev 表示标准差,rounds 为实际执行轮数。判断性能差异是否真实,需重点观察 stddev 与 mean 的比例:若标准差超过均值的10%,说明波动较大,差异可能源于系统噪声而非代码本身。可通过 pytest --benchmark-sort=mean 按均值排序快速定位更快实现。当两个实现的均值差异显著且标准差较小、置信区间无重叠时,方可认定存在稳定性能差距。建议结合多次独立运行结果交叉验证,避免单次统计异常误导结论。

展示真实pytest-benchmark命令行统计结果或benchmark结果表,突出mean、median、rounds和标准差等性能指标。
真实pytest-benchmark测试输出,集中展示Mean、StdDev、Median、IQR、Outliers、Rounds和Iterations等指标。

保存基准结果并进行回归验证

基准测试的价值在于长期追踪。通过添加 --benchmark-save=baseline_name 参数,pytest-benchmark 会将当前结果保存至 .benchmarks/ 目录下的 JSON 文件中。后续代码优化或依赖升级后,执行 pytest --benchmark-compare=baseline_name 即可自动对比历史数据,输出差异百分比。若性能下降超过预设阈值(如配合 --benchmark-fail-on-regression 参数),测试将直接报错,阻断合并。在 CI/CD 流水线中,可将基准结果导出为 CSV 并归档,结合版本标签建立性能基线库。该流程确保每次提交都经过可量化的性能回归检查,防止隐性劣化累积,形成可持续的性能治理闭环。
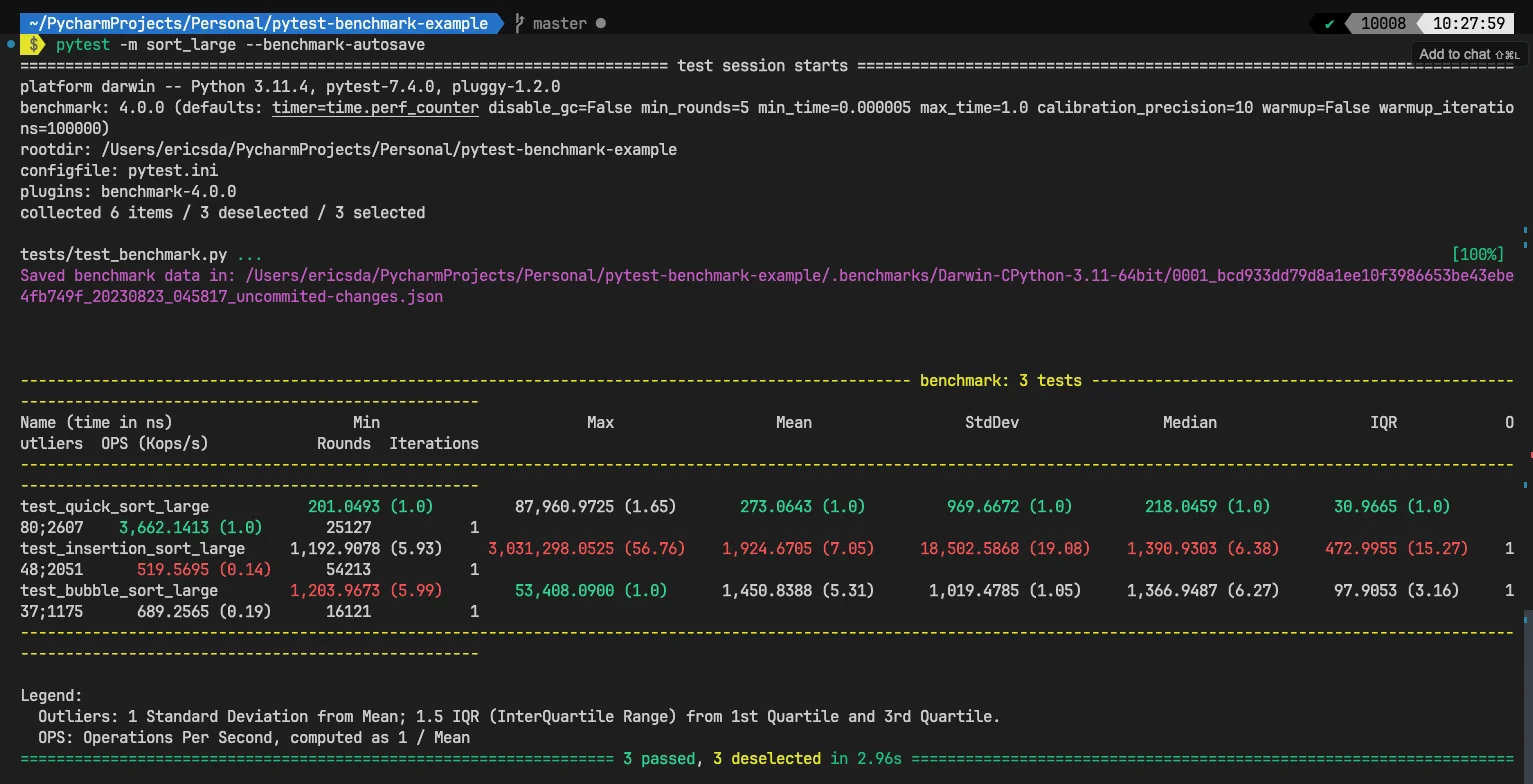
展示真实项目中pytest-benchmark保存和比较历史测试结果的终端输出,体现优化前后性能变化与回归检测。
真实终端中的benchmark autosave结果,展示历史基准数据保存到.benchmarks目录的过程。

性能基准测试常见误区与避坑

性能基准测试极易受环境干扰,常见误区包括:未锁定CPU频率导致动态降频拉长耗时;后台进程抢占CPU造成随机波动;内存缓存命中使首次运行偏慢;测试数据规模过小无法体现算法复杂度差异;使用未设种子的随机输入导致每次结果不可复现;将文件读写或网络请求混入纯计算基准;以及仅凭单次运行结果下结论。为提高稳定性与可解释性,应在专用测试机运行,固定CPU策略,使用 benchmark.pedantic 精确控制预热与迭代,对I/O操作进行Mock隔离,并确保输入数据规模贴近生产场景。同时,始终依赖多轮统计指标而非绝对时间,结合系统监控排除异常值,才能获得具备工程指导意义的基准结论。
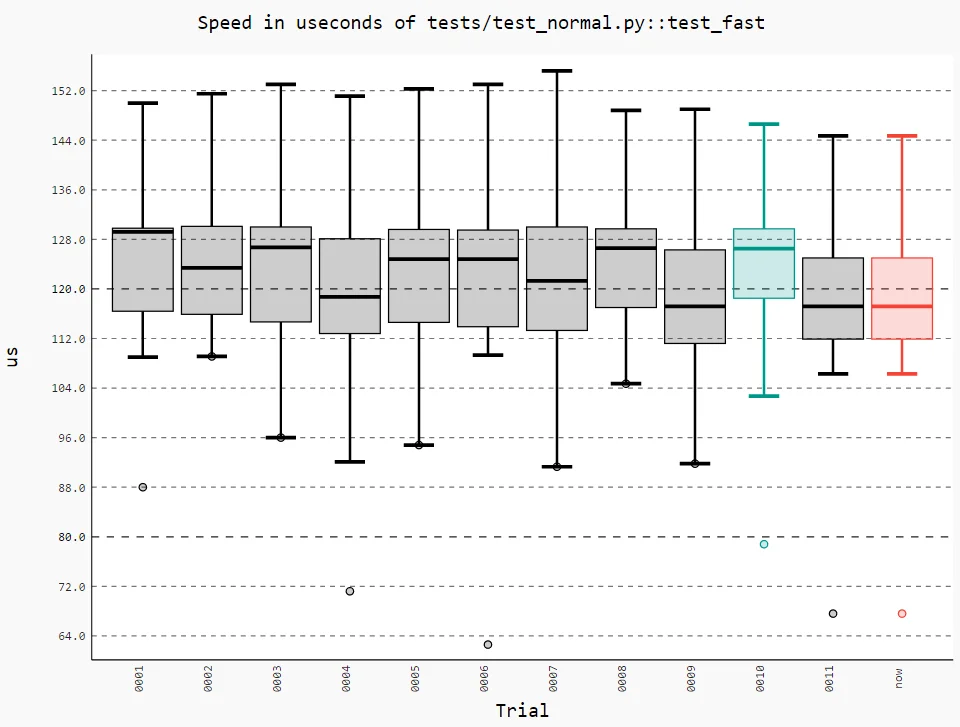
展示真实Python性能测试环境或pytest-benchmark报告,并直观体现测试波动、异常值和不稳定基准结果。
pytest-benchmark官方箱线图示例,直观展示测试波动范围及异常值。

游乐网为非赢利性网站,所展示的游戏/软件/文章内容均来自于互联网或第三方用户上传分享,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系youleyoucom@outlook.com。

同类文章
更多
用 pytest-benchmark 建立可复现的性能基线:从对比到回归

用 pytest-benchmark 建立可复现的性能基线:从对比到回归

本文介绍如何利用 pytest-benchmark 为 Python 代码建立可重复的性能基准,通过基准测试、对比分析和结果验证定位性能差异,同时避免测试环境、数据规模和统计方式带来的误判。

时间:2026-10-09 20:56
Python数据清洗:缺失值处理与异常值检测

Python数据清洗:缺失值处理与异常值检测

系统掌握使用Python与Pandas进行数据清洗的方法,从识别缺失值、选择合理的填补或删除策略,到检测异常值并验证清洗效果,避免因盲目处理导致数据偏差。

时间:2026-10-09 20:51
SQLAlchemy 事务避坑指南:Session 生命周期与异常处理

SQLAlchemy 事务避坑指南:Session 生命周期与异常处理

在 SQLAlchemy 开发中,Session 不仅是对象状态的跟踪器,更是数据库事务的边界载体。许多数据不一致问题源于对 Session 生命周期、事务提交机制及异常回滚的误解。本文从 Session 的工作单元本质出发,解析 flush 与 commit 的行为差异,探讨并发场景下的请求级 S

时间:2026-10-09 20:46
Redis 与 Memcached 选型指南:从架构差异到生产实践

Redis 与 Memcached 选型指南:从架构差异到生产实践

本文不单纯比较 QPS 峰值,而是从架构原理出发,解析 Redis 与 Memcached 在数据模型、内存管理与并发处理上的本质差异。通过统一环境的基准测试与真实业务场景分析,揭示在 Session 存储、复杂数据结构及高并发读写下的性能表现与瓶颈。文章最后提供针对缓存穿透、雪崩及大 Key 问题

时间:2026-10-09 20:41
Linux服务器初始化:防火墙与SELinux策略配置

Linux服务器初始化:防火墙与SELinux策略配置

从服务器初始化安全基线出发,系统梳理防火墙规则与SELinux策略的配置、验证、联动排障及常见避坑方法,帮助在保证服务可用的同时建立合理的访问控制边界。

时间:2026-10-09 20:36
热门专题
更多
刀塔传奇破解版无限钻石下载大全 刀塔传奇破解版无限钻石下载大全
洛克王国正式正版手游下载安装大全 洛克王国正式正版手游下载安装大全
思美人手游下载专区 思美人手游下载专区
好玩的阿拉德之怒游戏下载合集 好玩的阿拉德之怒游戏下载合集
不思议迷宫手游下载合集 不思议迷宫手游下载合集
百宝袋汉化组游戏最新合集 百宝袋汉化组游戏最新合集
jsk游戏合集30款游戏大全 jsk游戏合集30款游戏大全
宾果消消消原版下载大全 宾果消消消原版下载大全


