Session 的工作单元与事务边界
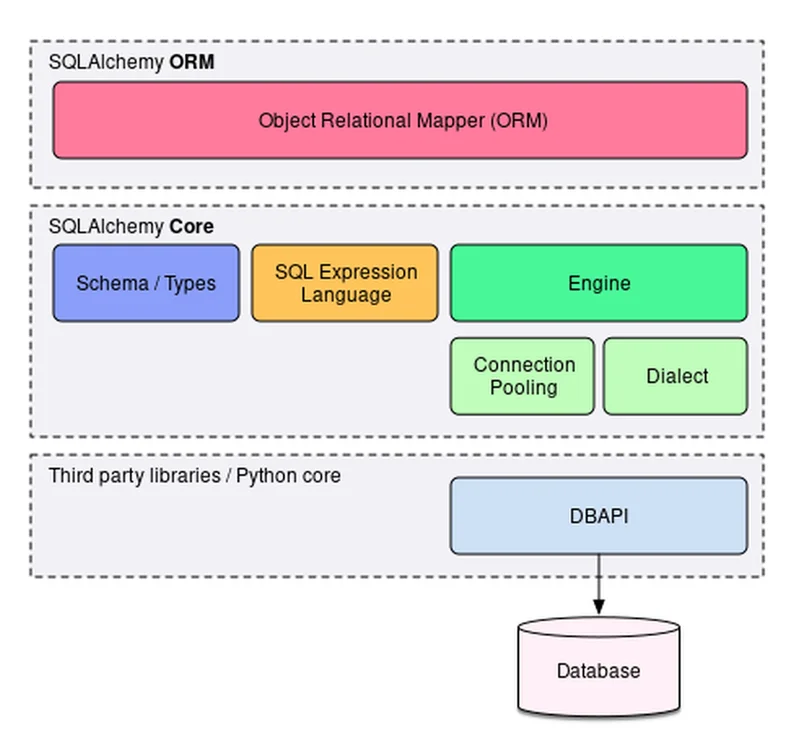
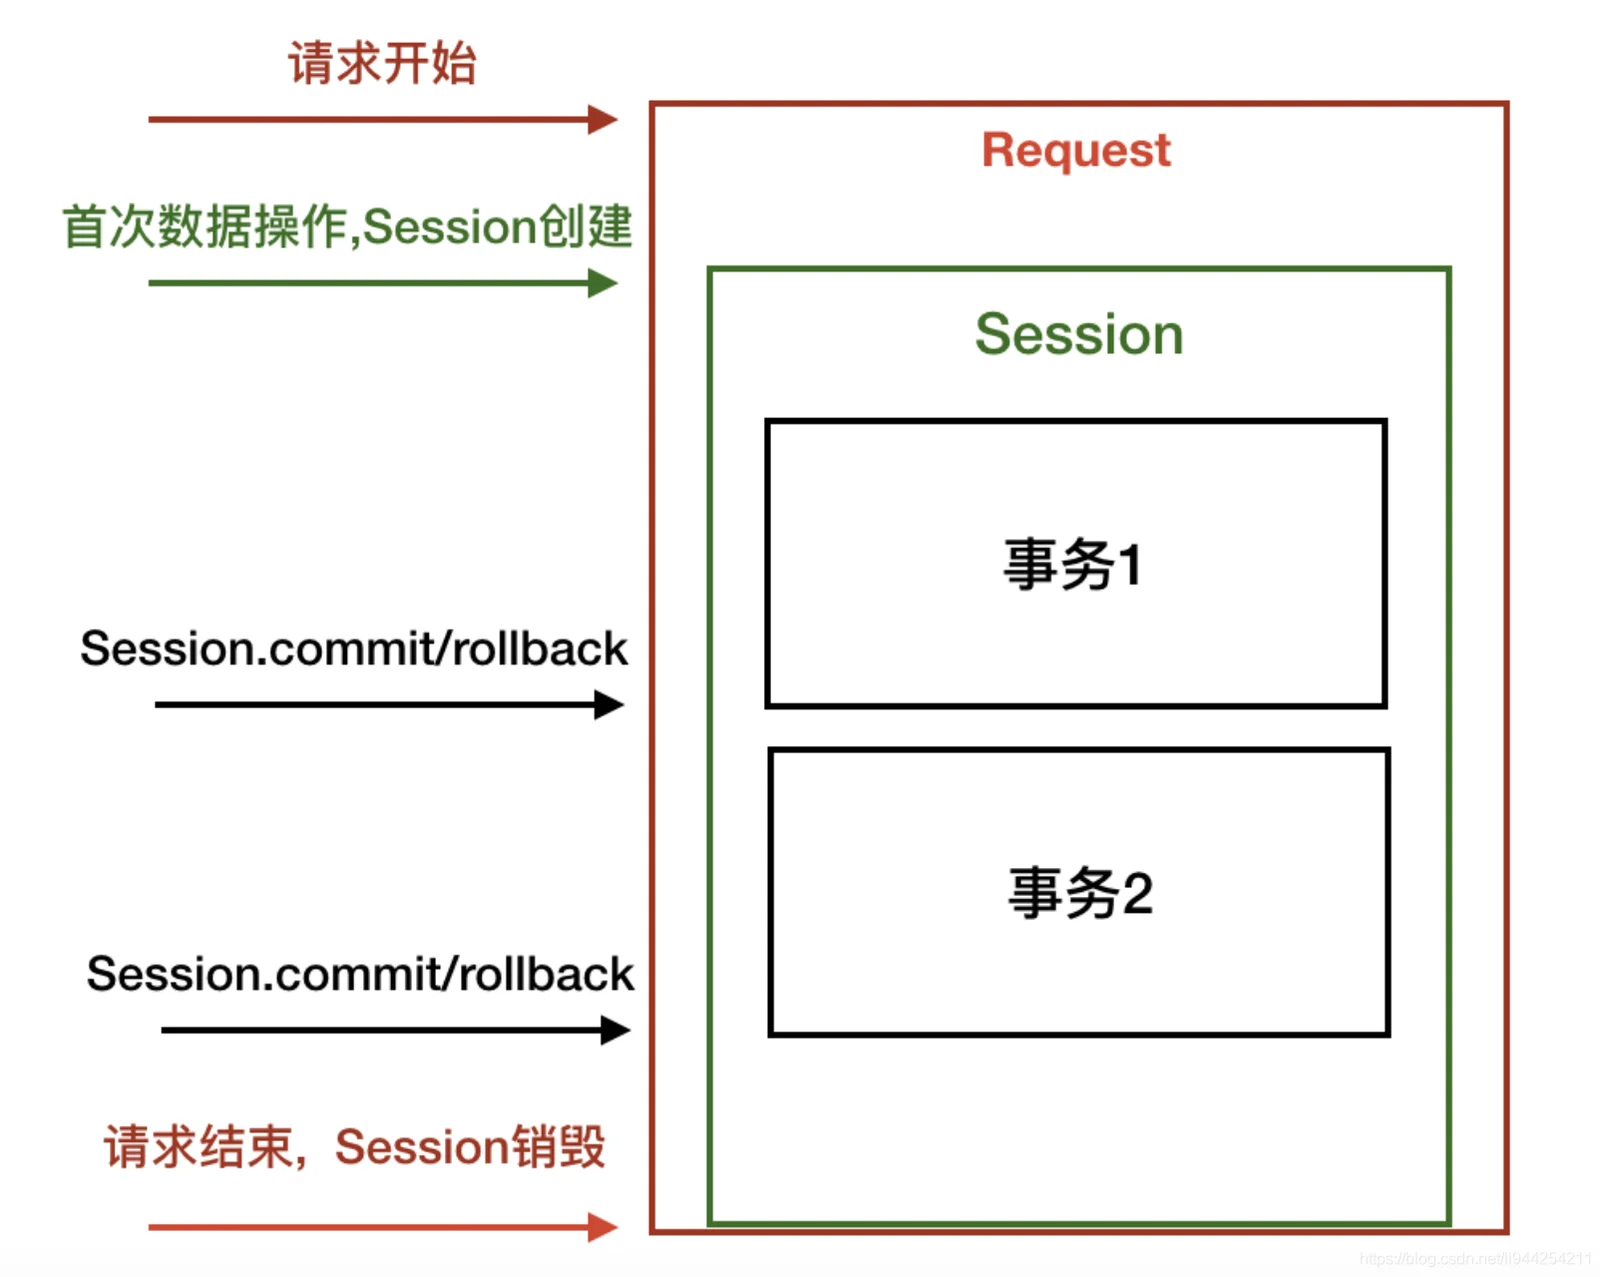
SQLAlchemy 的 Session 是 ORM 层的核心工作单元,它负责跟踪对象状态、生成 SQL 语句并维护数据库事务。需要明确的是,Session 本身并不直接连接数据库,而是通过 Engine 从连接池中获取 Connection 来执行具体操作。当使用 sessionmaker() 创建 Session 工厂并实例化 Session 时,即开启了一个工作单元。默认情况下,Session 会在首次执行数据库操作(如查询或添加对象)时自动隐式开启事务(BEGIN)。
Session 的生命周期应严格遵循短生命周期原则:在需要执行一组相关操作时创建,操作完成后立即提交或回滚并关闭(session.close())。切勿在应用全局复用同一个 Session 实例,否则会导致状态混乱和内存泄漏。正确的做法是在函数或请求作用域内通过上下文管理器创建,确保每个工作单元独立且边界清晰。
提交、回滚与事务上下文管理
在事务管理中,明确各方法的区别至关重要。session.add() 仅将对象标记为待插入,不触发 SQL;session.flush() 将待处理状态同步至数据库,生成 INSERT 或 UPDATE 语句但事务未提交,主键可提前获取;session.commit() 正式提交事务并释放数据库锁;session.rollback() 则撤销所有未提交的更改并重置 Session 状态。
推荐使用 session.begin() 上下文管理器实现原子操作。例如使用 with session.begin(): 包裹业务逻辑,该结构会在代码块正常结束时自动调用 commit,若抛出异常则自动执行 rollback,避免手动管理遗漏。结合 try-except 可进一步细化错误处理,确保业务逻辑失败时数据一致性不受破坏,同时避免残留的脏数据影响后续操作。

并发会话与常见事务陷阱
Session 并非线程安全,严禁在多线程或不同 HTTP 请求间共享同一实例,否则将引发竞态条件与数据错乱。在 Web 框架中,应采用请求级 Session 模式,即每个请求初始化独立 Session,响应结束后统一清理。
常见陷阱包括:事务嵌套导致隐式保存点行为不符合预期,可通过配置 savepoint=True 或改用独立 Session 隔离;长事务占用数据库连接池资源,应拆分大事务或优化查询逻辑;异常发生后继续复用 Session 会触发 InvalidRequestError,因为 Session 已进入失效状态。规避方法是捕获异常后立即调用 session.rollback() 重置状态,或依赖上下文管理器自动清理。始终遵循一次请求一个事务或明确边界的小事务原则,可大幅提升系统稳定性。
验证事务结果与排查会话问题
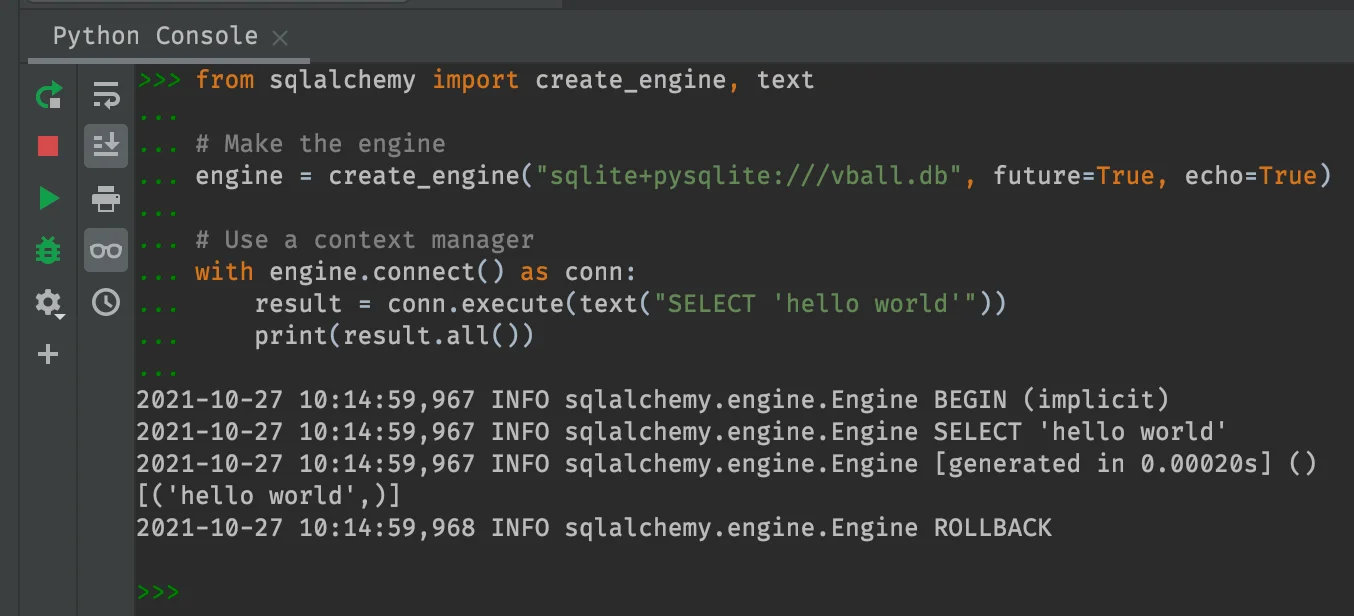
验证事务是否生效需结合代码查询、日志输出与数据库直连检查。开启 echo=True 可在控制台打印完整 SQL 流,观察 BEGIN、COMMIT 或 ROLLBACK 标记是否按预期出现。若提交后查询不到数据,通常因未调用 commit() 或事务被静默回滚。
排查时需注意:调用 session.close() 后对象变为分离状态,再次访问延迟加载属性会报错,应使用 session.expunge() 或提前加载关联数据。未提交数据仅存在于 Session 缓存中,可通过 session.dirty 与 session.new 属性检查待同步对象。若遇到事务状态异常,可调用 session.in_transaction() 确认当前状态,并检查是否因连接池耗尽或死锁导致隐式回滚。结合数据库事务隔离级别与 ORM 日志交叉比对,能快速定位会话管理缺陷。