





理解 seccomp 与 capabilities 的安全边界
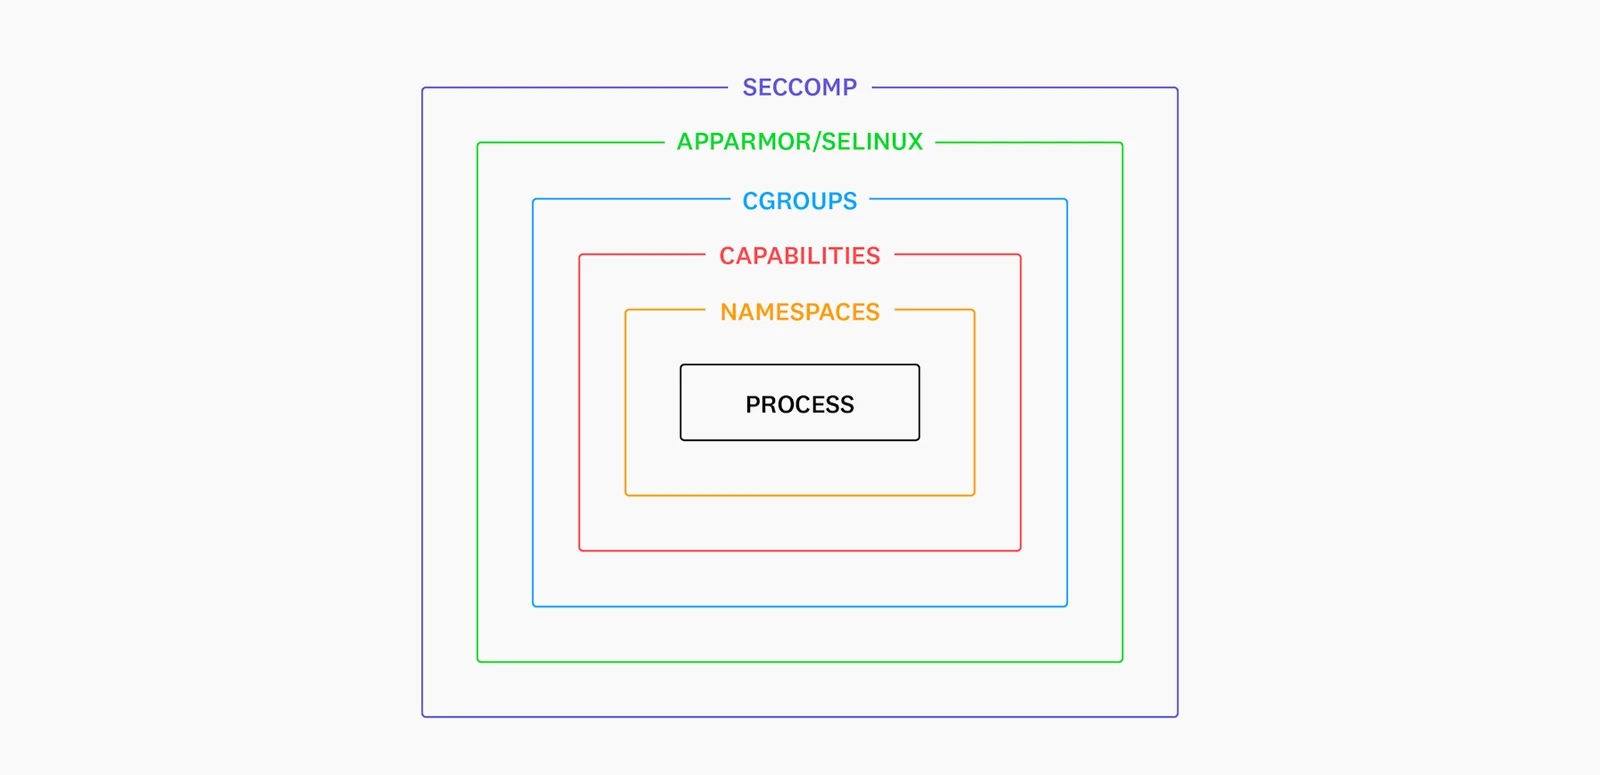
在容器安全体系中,最小权限原则是核心指导思想。Linux 内核提供了两种关键机制来实现该原则:seccomp(Secure Computing Mode)与 Linux capabilities。seccomp 工作在系统调用(syscall)层面,通过白名单或黑名单过滤容器进程对内核 API 的访问,从而阻止如 mount、ptrace 或 reboot 等底层操作。相比之下,capabilities 机制将传统超级用户(root)的绝对权限拆分为数十个细粒度的独立能力(如 CAP_NET_BIND_SERVICE 允许绑定低端口,CAP_SYS_ADMIN 允许执行系统管理任务)。两者职责边界清晰且高度互补:capabilities 决定进程“能做什么特权操作”,而 seccomp 决定进程“能调用哪些内核接口”。Docker 默认已启用内置的 seccomp 配置文件,并自动移除了部分高风险 capabilities(如 CAP_SYS_ADMIN、CAP_NET_RAW),为容器提供了开箱即用的基础安全隔离。理解这一边界,是后续进行精细化权限管控的前提。
使用 capabilities 实施最小权限限制
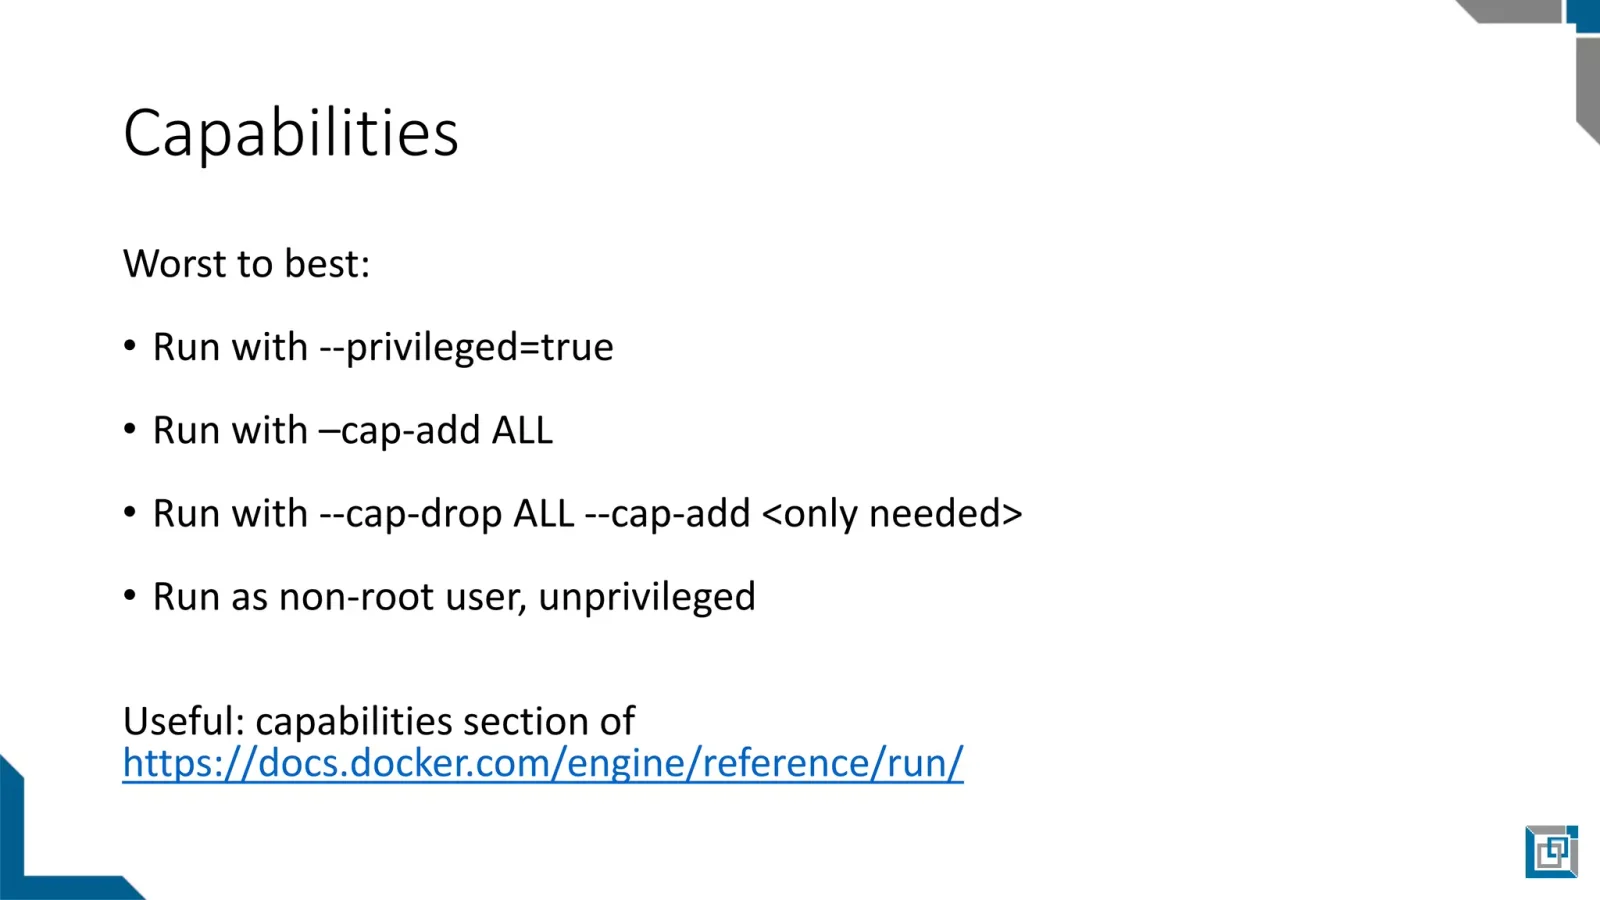
实施最小权限的第一步是合理裁剪容器的 capabilities。Docker 默认赋予容器一组基础能力,但多数业务应用并不需要全部权限。可通过 --cap-drop 移除默认能力,再使用 --cap-add 按需恢复。例如,运行一个仅需监听 80 端口的 Web 服务时,可执行: docker run --cap-drop ALL --cap-add NET_BIND_SERVICE nginx 该命令剥离了所有特权,仅保留绑定特权端口的权限。验证配置是否生效,可在容器内安装 libcap2-bin 后运行 capsh --print,或在宿主机使用 docker inspect <容器ID> --format='{{.HostConfig.CapDrop}}' 查看实际生效的权限列表。务必避免在生产环境中直接使用 --privileged 标志,该参数会赋予容器完整的 root 权限并挂载所有设备,彻底破坏容器隔离边界。通过按需授权,可显著降低容器逃逸风险。
配置 seccomp 限制危险系统调用
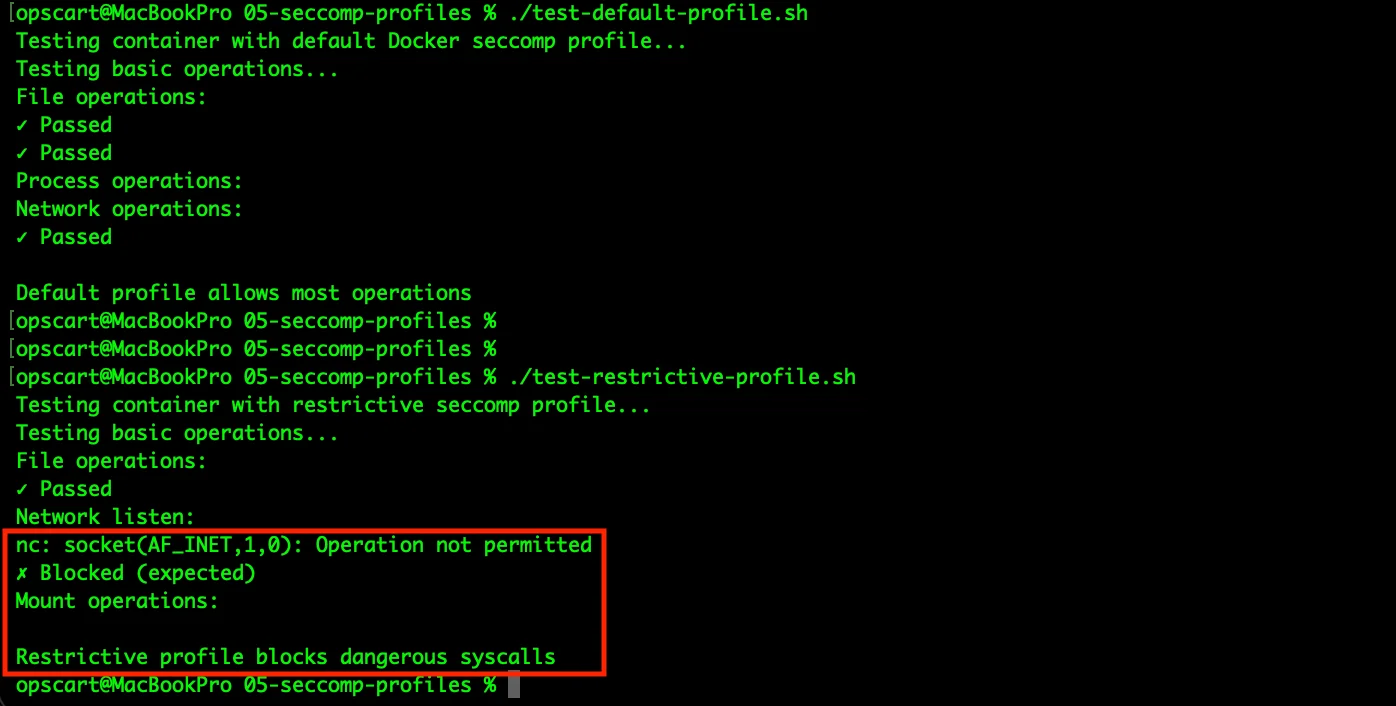
Docker 默认的 seccomp 策略采用白名单机制,仅放行约 300 个常用系统调用,其余默认拦截。若需进一步收紧策略,可通过 --security-opt seccomp=
组合验证与安全加固避坑
在实际生产加固中,capabilities 与 seccomp 必须协同工作。单一机制的防护往往存在盲区:仅限制 capabilities 无法阻止恶意进程利用合法 syscall 进行越权;仅依赖 seccomp 则可能遗漏未过滤的特权操作。验证组合策略时,可模拟攻击场景,例如在容器内尝试挂载文件系统(需 CAP_SYS_ADMIN 且调用 mount syscall)或注入进程(需 CAP_SYS_PTRACE 且调用 ptrace)。若配置正确,操作将立即被内核拒绝。避坑的核心在于“渐进式收紧”:切勿为追求绝对安全而直接套用极端策略,应先以默认配置运行应用,通过 strace 或 auditd 抓取实际 syscall 调用链,再逐步 drop 冗余 capabilities 并裁剪 seccomp 白名单。遇到兼容性问题时,应优先排查应用是否依赖过时或高危接口,而非简单回退至 --privileged 或 unconfined 状态。安全加固是一个持续迭代的过程,需结合业务特性动态调整。







