理解find与locate的查找原理与适用场景
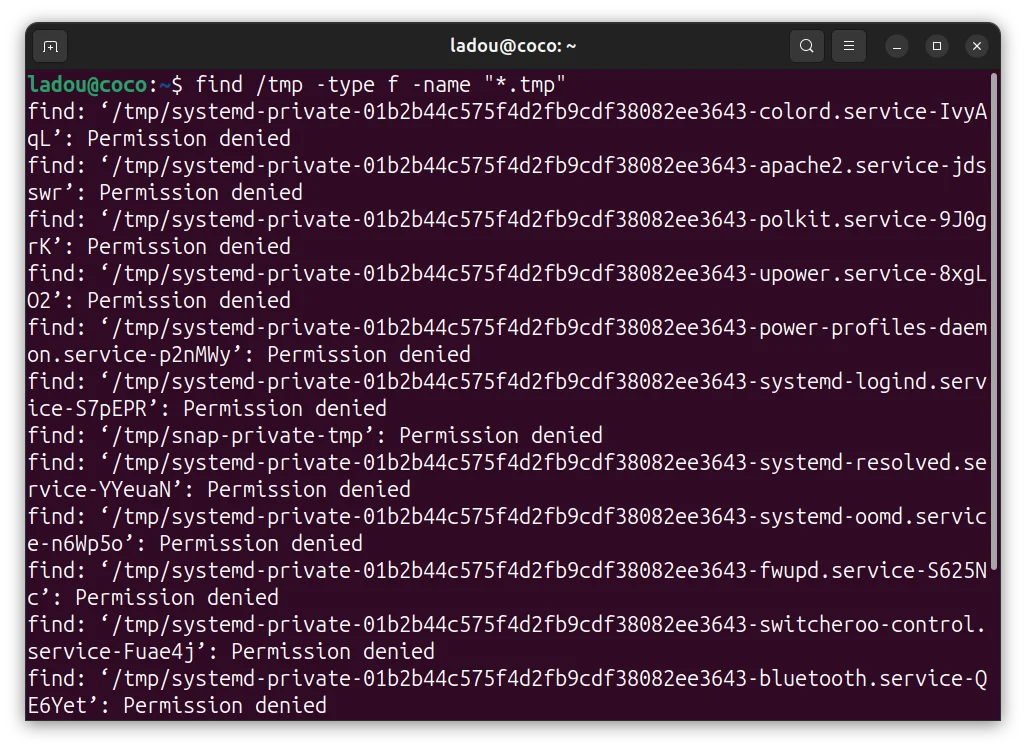
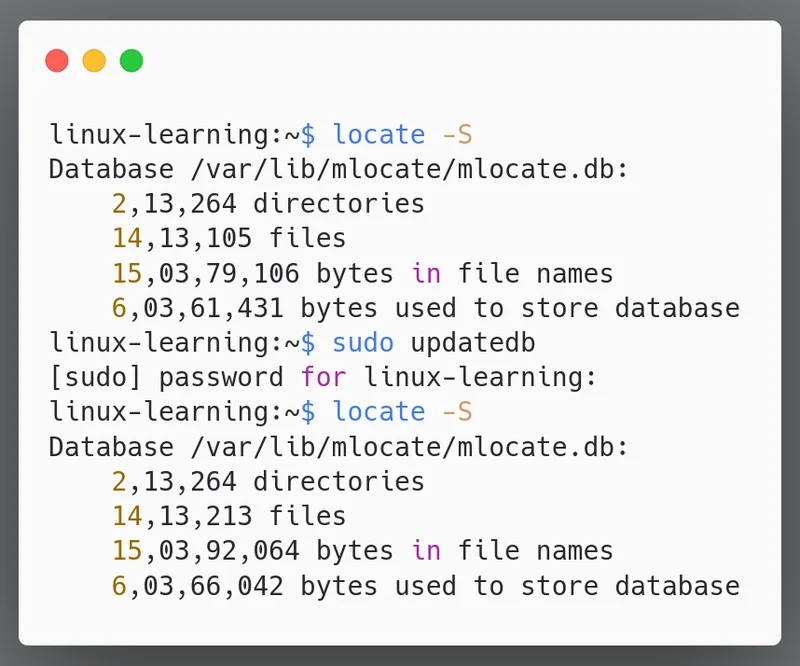
find与locate的核心差异在于底层检索机制。find命令采用实时遍历策略,从指定起始目录开始递归扫描文件系统树,直接读取目录项与inode元数据,因此能即时反映文件的创建、删除或移动状态。这种机制使其天然支持复杂的组合条件,如按修改时间、权限、所有者或文件类型进行过滤,但代价是较高的磁盘I/O开销。相比之下,locate并不直接扫描磁盘,而是依赖由updatedb定期生成的系统级数据库(通常位于/var/lib/mlocate/mlocate.db)。查询时,locate仅对内存中的数据库索引进行二分或哈希匹配,因此速度极快,通常在毫秒级返回结果。然而,数据库的更新存在延迟,导致locate无法感知最近几分钟内新增或变更的文件。在适用场景上,若需精确匹配复杂属性或获取绝对实时结果,find是首选;若仅需快速定位已知名称的静态文件,locate则能大幅降低系统负载。
掌握find与locate的常用查找操作
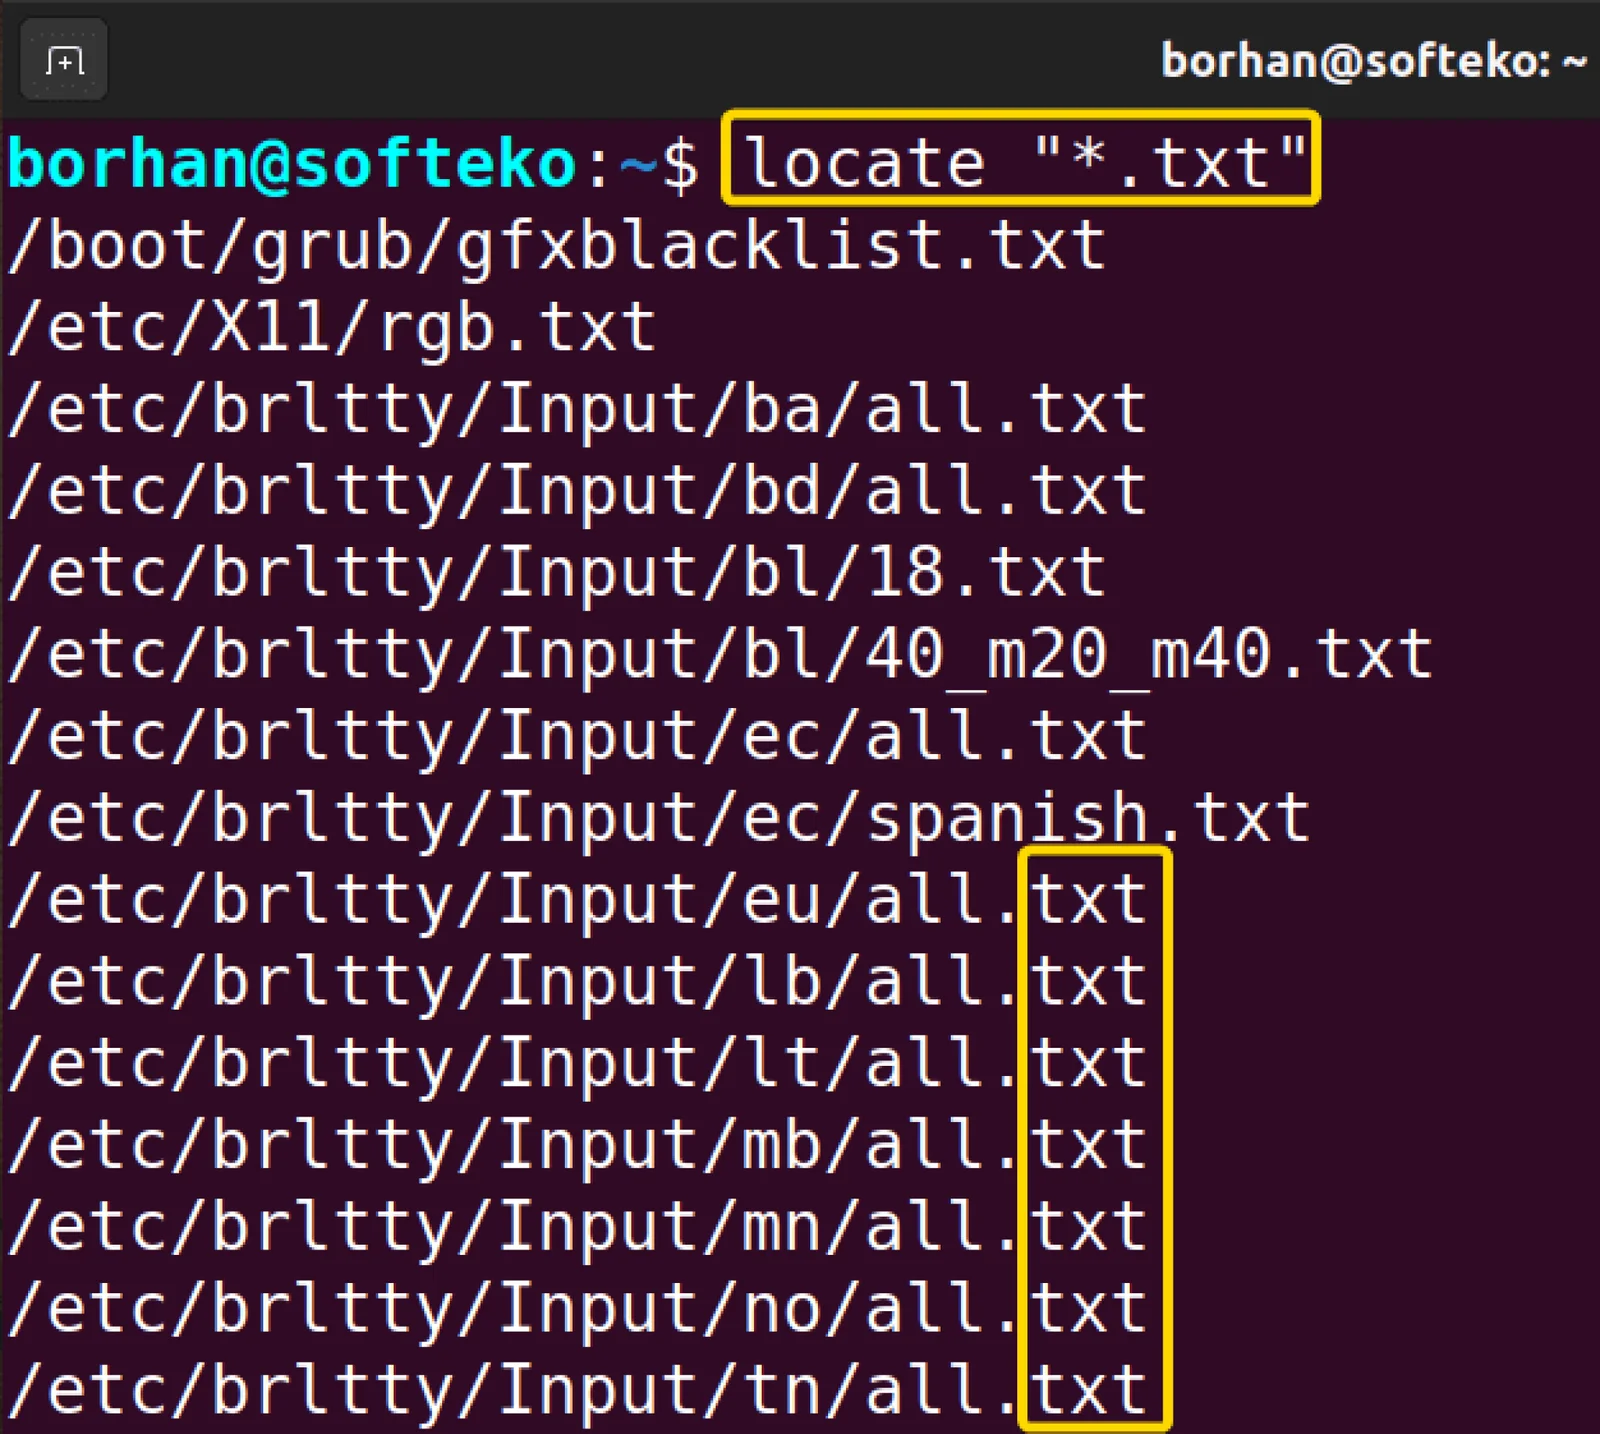
在实际操作中,find提供了高度灵活的参数体系。按名称查找可使用find /home -name "*.log",配合-iname可忽略大小写;结合-type f限定普通文件,-mtime -7筛选七天内修改过的文件,还能通过-exec或-delete直接执行后续操作。路径匹配支持-path与-regex,适合处理深层嵌套目录。locate的用法则更为精简,默认执行locate 文件名即可快速检索,支持通配符如locate "*.conf"。若需精确匹配完整路径,可添加-b参数仅匹配基名,或使用-r启用正则表达式。值得注意的是,普通用户运行locate时,受限于数据库权限过滤,无法看到其他用户或系统保护的私有文件;此时需使用sudo locate以获取完整结果。此外,locate默认不区分大小写,若需严格匹配可配合-i或调整环境变量。两者在通配符解析上均依赖Shell展开,建议在参数外加单引号防止意外展开。
通过基准测试对比实际查找效率
为客观对比两者效率,可设计可复现的基准测试。在包含数万文件的典型目录(如/usr或/var)中,使用time命令分别执行find /usr -name "*.so"与locate "*.so"。首次运行前,建议执行echo 3 > /proc/sys/vm/drop_caches清除页缓存,以排除内存缓存对find的加速干扰。测试结果表明,locate的耗时通常稳定在0.01至0.05秒之间,因其仅需读取已加载的数据库索引;而find的耗时受磁盘介质与目录深度影响显著,在机械硬盘上可能需0.5至数秒,SSD环境下可缩短至0.1秒左右,但仍远高于locate。若查询条件增加(如叠加-size +1M或-user www),find需逐文件校验元数据,耗时呈线性增长;locate则因仅支持名称匹配,无法直接执行此类测试。缓存机制对结果影响极大:若系统已频繁访问目标目录,find的页缓存命中会大幅降低I/O延迟,此时两者差距缩小。因此,性能对比必须结合磁盘类型、缓存状态与查询复杂度综合评估。
根据场景选择工具并避开常见误区
工具选择应严格匹配业务场景。对于日常快速定位配置文件或日志,且系统处于稳定运行状态时,locate凭借极低延迟成为首选;若需排查刚生成的错误日志、按权限或时间范围清理临时文件,或在自动化脚本中实现动态过滤,则必须依赖find的实时性与多维条件支持。常见误区包括:误以为locate能实时反映文件变动,导致脚本因找不到新文件而报错;此时应在关键任务前手动执行sudo updatedb强制刷新数据库。权限范围也是易错点,普通用户执行locate受限于prune规则,无法检索受限目录,需结合sudo或调整/etc/updatedb.conf配置。此外,find在遍历网络文件系统(如NFS)或挂载点时可能引发阻塞,建议通过-xdev限制单文件系统,或使用-path /proc -prune -o排除虚拟文件系统。对于结果过期问题,locate依赖cron定时任务更新,若服务器长期休眠,数据库将严重滞后,此时应优先使用find或手动触发更新。