




Python使用Spire.XLS自动化拆分Excel的四大场景实现

借助Spire XLSforPython,可自动化拆分Excel文件,实现按工作表、行、列及指定条件四种场景。通过遍历工作表、复制行或列数据,将重复劳动交由代码完成,大幅提升数据处理效率,节省时间与人力。
环境准备
在开始拆分操作之前,需要先安装好依赖库。Spire.XLS for Python 是一个功能丰富的 Excel 文档处理组件,支持创建、读取、修改、格式转换等操作,且无需安装 Microsoft Office。通过 pip 安装即可:pip install spire.xls此外,该组件还提供免费版,适合小项目或测试场景。安装完成后,导入模块即可开始使用:
from spire.xls import *
from spire.xls.common import *
本文会用到以下几个核心对象,先列出表格便于理解:
| 对象 | 作用 |
|---|---|
| Workbook | 代表整个 Excel 工作簿 |
| Worksheet | 代表工作簿中的工作表 |
| Range | 代表单元格区域 |
通过 Python 按工作表拆分 Excel 文件
一个 Excel 工作簿往往包含多个工作表,例如不同月份的数据、不同地区的报表。若希望将每个工作表单独保存为一个 Excel 文件,只需遍历 Workbook 中的 Worksheet,然后逐个复制到新工作簿即可。 使用 Spire.XLS 实现起来非常简便:加载原始文件,遍历所有工作表,创建新 Workbook,用AddCopy() 方法复制工作表。具体步骤如下:
- 创建 Workbook 对象并加载 Excel 文件;
- 遍历工作簿中的所有 Worksheet;
- 创建新的 Workbook;
- 使用 AddCopy() 方法复制工作表;
- 保存生成的 Excel 文件。
from spire.xls import *
from spire.xls.common import *

# 创建 Workbook 对象并加载 Excel 文件
workbook = Workbook()
workbook.LoadFromFile("/input/示例.xlsx")

# 设置拆分后文件的保存路径
output_path = "/output/按表拆分/"

# 遍历工作簿中的所有工作表
for sheet in workbook.Worksheets:

    # 创建新的 Workbook 对象,并删除默认工作表
    new_workbook = Workbook()
    new_workbook.Worksheets.Clear()

    # 将当前工作表复制到新的工作簿中
    new_workbook.Worksheets.AddCopy(sheet)

    # 以当前工作表名称命名,并保存为独立的 Excel 文件
    new_workbook.Sa veToFile(
        output_path + sheet.Name + ".xlsx",
        FileFormat.Version2016
    )

    # 释放资源
    new_workbook.Dispose()

workbook.Dispose()
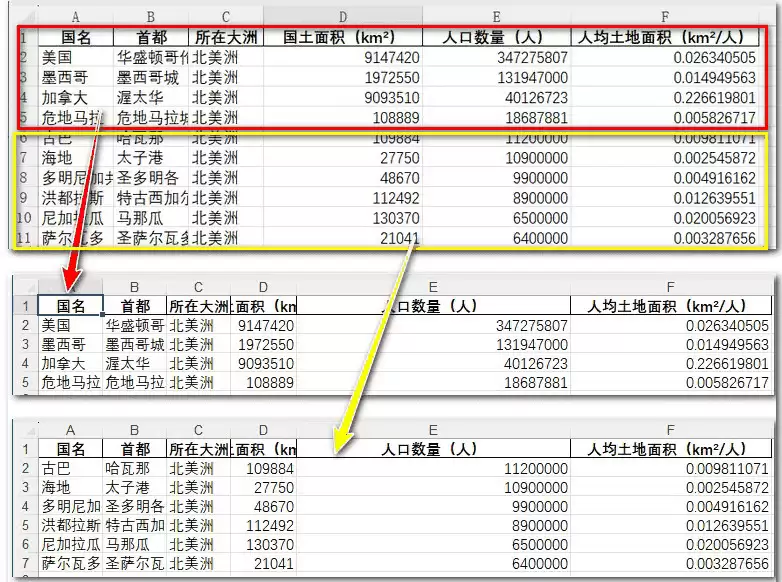
运行后,原 Excel 中的每个工作表都会单独保存成一个新文件,文件名即为工作表名称。

通过 Python 按行拆分 Excel 文件
除了按工作表拆分,按行拆分也是常见需求——当一个工作表数据量过大时,可以按固定行数切分成多个文件,便于后续处理。例如,先获取总行数,设定每个文件包含的行数,然后通过CopyRow() 方法将指定范围的数据复制到新工作簿。
实现步骤如下:
- 加载 Excel 文件;
- 获取工作表数据行数;
- 设置每个文件包含的行数;
- 创建新的 Workbook;
- 复制指定行数据并保存。
from spire.xls import *
from spire.xls.common import *

# 创建 Workbook 对象并加载 Excel 文件
workbook = Workbook()
workbook.LoadFromFile("/input/示例.xlsx")

# 获取第一个工作表
worksheet = workbook.Worksheets[0]

# 设置文件保存路径
folderPath = "/output/按行拆分/"

# 将第 1-5 行拆分到新文件
newWorkbook1 = Workbook()
newWorkbook1.Worksheets.Clear()
newWorksheet1 = newWorkbook1.Worksheets.Add("Sheet1")

for i in range(1, 6):
    worksheet.CopyRow(
        worksheet.Rows[i - 1],
        newWorksheet1,
        newWorksheet1.LastDataRow + 1,
        CopyRangeOptions.All
    )

# 复制列宽
for i in range(worksheet.Columns.Count):
    newWorksheet1.SetColumnWidth(
        i + 1,
        worksheet.GetColumnWidth(i + 1)
    )

newWorkbook1.Sa veToFile(folderPath + "1-5行.xlsx", FileFormat.Version2016)
newWorkbook1.Dispose()

# 将第 6-11 行拆分到新文件(先复制表头)
newWorkbook2 = Workbook()
newWorkbook2.Worksheets.Clear()
newWorksheet2 = newWorkbook2.Worksheets.Add("Sheet1")

# 复制表头(第1行)
worksheet.CopyRow(
    worksheet.Rows[0],
    newWorksheet2,
    newWorksheet2.LastDataRow + 1,
    CopyRangeOptions.All
)

# 复制第6-11行数据
for i in range(6, 12):
    worksheet.CopyRow(
        worksheet.Rows[i - 1],
        newWorksheet2,
        newWorksheet2.LastDataRow + 1,
        CopyRangeOptions.All
    )

for i in range(worksheet.Columns.Count):
    newWorksheet2.SetColumnWidth(
        i + 1,
        worksheet.GetColumnWidth(i + 1)
    )

newWorkbook2.Sa veToFile(folderPath + "6-11行.xlsx", FileFormat.Version2016)
newWorkbook2.Dispose()

workbook.Dispose()
通过 Python 按列拆分 Excel 文件
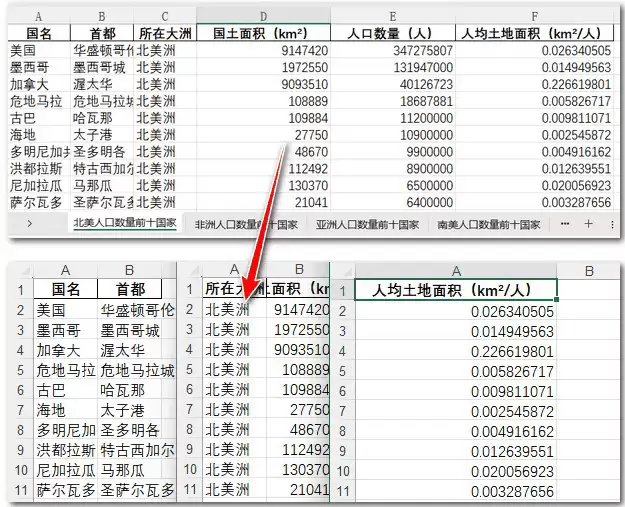
有时我们并不需要拆分整张表,而是只想提取其中某些列。例如,一个表格中同时包含了员工基础信息、销售记录和财务数据,但这些内容需要分发给不同的人员查看。此时可以按列的位置拆分,将指定范围内的列复制到新工作簿中。Spire.XLS 提供了CopyColumn() 方法,能够保留原有的单元格格式。
实现步骤:
- 创建新的 Workbook;
- 添加新的 Worksheet;
- 使用 CopyColumn() 复制目标列;
- 设置行高并保存文件。
from spire.xls import *
from spire.xls.common import *

workbook = Workbook()
workbook.LoadFromFile("/input/示例.xlsx")
worksheet = workbook.Worksheets[0]
folderPath = "/output/按列拆分/"

# 拆分第 1-2 列(A-B列)
newWorkbook1 = Workbook()
newWorkbook1.Worksheets.Clear()
newWorksheet1 = newWorkbook1.Worksheets.Add("Sheet1")

for i in range(1, 3):
    worksheet.CopyColumn(
        worksheet.Columns[i - 1],
        newWorksheet1,
        newWorksheet1.LastDataColumn + 1,
        CopyRangeOptions.All
    )

for i in range(worksheet.Rows.Count):
    newWorksheet1.SetRowHeight(i + 1, worksheet.GetRowHeight(i + 1))

newWorkbook1.Sa veToFile(folderPath + "AB.xlsx", FileFormat.Version2016)
newWorkbook1.Dispose()

# 拆分第 3-5 列(C-E列)
newWorkbook2 = Workbook()
newWorkbook2.Worksheets.Clear()
newWorksheet2 = newWorkbook2.Worksheets.Add("Sheet1")

for i in range(3, 6):
    worksheet.CopyColumn(
        worksheet.Columns[i - 1],
        newWorksheet2,
        newWorksheet2.LastDataColumn + 1,
        CopyRangeOptions.All
    )

for i in range(worksheet.Rows.Count):
    newWorksheet2.SetRowHeight(i + 1, worksheet.GetRowHeight(i + 1))

newWorkbook2.Sa veToFile(folderPath + "CDE.xlsx", FileFormat.Version2016)
newWorkbook2.Dispose()

# 拆分第 6 列(F列)
newWorkbook3 = Workbook()
newWorkbook3.Worksheets.Clear()
newWorksheet3 = newWorkbook3.Worksheets.Add("Sheet1")

worksheet.CopyColumn(
    worksheet.Columns[5],
    newWorksheet3,
    newWorksheet3.LastDataColumn + 1,
    CopyRangeOptions.All
)

for i in range(worksheet.Rows.Count):
    newWorksheet3.SetRowHeight(i + 1, worksheet.GetRowHeight(i + 1))

newWorkbook3.Sa veToFile(folderPath + "F.xlsx", FileFormat.Version2016)
newWorkbook3.Dispose()

workbook.Dispose()
实践:通过 Python 按指定条件拆分 Excel
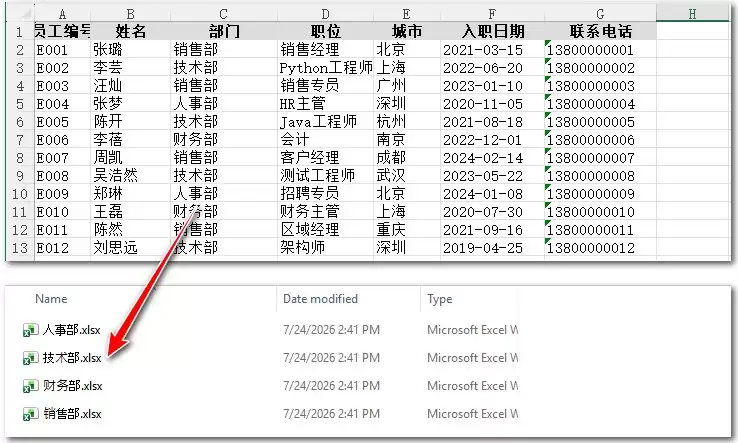
前面介绍的几种拆分方式均基于固定规则,但在实际工作中,更常见的需求是根据 Excel 某一列中的内容进行分类拆分。例如,员工信息表中的“部门”列包含销售部、技术部、人事部等,希望自动将同一部门的数据整理到一个独立文件中;销售数据也可按地区、月份生成不同报表。这种按条件拆分的方式更贴合实际,无需手动筛选复制,自动生成符合业务规则的独立文件。 下面以“按照员工部门拆分 Excel”为例。假设员工信息表中包含姓名、部门、职位等字段,期望自动生成:每个文件仅保存对应部门的员工数据。 实现流程:销售部.xlsx
技术部.xlsx
人事部.xlsx
- 加载 Excel 文件;
- 指定拆分依据的列;
- 遍历数据行并获取分类值;
- 根据分类值创建新的 Workbook;
- 复制对应数据行;
- 保存生成的 Excel 文件。
from spire.xls import *
from spire.xls.common import *

# 加载 Excel 文件
workbook = Workbook()
workbook.LoadFromFile("/员工信息.xlsx")

# 获取第一个工作表
worksheet = workbook.Worksheets[0]

# 输出目录
folderPath = "/output/按条件拆分/"

# 用于保存不同部门对应的 Workbook
department_books = {}

# 获取总行数
row_count = worksheet.Rows.Count

# 设置按部门拆分(假设部门在第3列)
department_column = 3

# 遍历数据行(跳过表头)
for i in range(1, row_count):
    # 获取部门名称
    department = worksheet.Range[i + 1, department_column].Value

    if department not in department_books:
        # 创建新的 Workbook
        newWorkbook = Workbook()
        newWorkbook.Worksheets.Clear()
        newWorksheet = newWorkbook.Worksheets.Add("Sheet1")

        # 复制表头
        worksheet.CopyRow(
            worksheet.Rows[0],
            newWorksheet,
            newWorksheet.LastDataRow + 1,
            CopyRangeOptions.All
        )

        department_books[department] = newWorkbook

    # 获取目标 Sheet
    newWorksheet = department_books[department].Worksheets[0]

    # 复制当前行
    worksheet.CopyRow(
        worksheet.Rows[i],
        newWorksheet,
        newWorksheet.LastDataRow + 1,
        CopyRangeOptions.All
    )

# 保存文件
for department, wb in department_books.items():
    wb.Sa veToFile(
        folderPath + department + ".xlsx",
        FileFormat.Version2016
    )
    wb.Dispose()

workbook.Dispose()
总结
Excel 拆分在数据整理中极为常见。通过 Python 结合 Spire.XLS,可以将原本需要手动复制、筛选、保存的步骤完全自动化,大幅提升工作效率。本文介绍了四种常见的拆分方式:- 按工作表拆分:适用于多个 Sheet 独立保存;
- 按行拆分:适用于大型数据文件的分割;
- 按列拆分:适用于字段分类与权限管理;
- 按条件拆分:适用于部门、地区、日期等实际业务场景。

游乐网为非赢利性网站,所展示的游戏/软件/文章内容均来自于互联网或第三方用户上传分享,版权归原作者所有,本站不承担相应法律责任。如您发现有涉嫌抄袭侵权的内容,请联系youleyoucom@outlook.com。
 同类文章

网络安全知识普及:常见攻击手法与防御机制详解
从“攻击者如何进入”到“系统如何防住、如何验证防御是否有效”,用通俗且可操作的方式梳理网络安全核心知识。内容覆盖钓鱼与账号攻击、漏洞与注入、恶意软件及拒绝服务等常见威胁,并结合纵深防御、最小权限、补丁管理、输入验证、日志监控等机制,帮助读者建立完整的安全防护思路。

网络安全宣传周活动策划:企业内网安全文化建设指南
以网络安全宣传周为契机,把一次性宣传活动升级为企业内网安全文化建设闭环:先识别风险与目标,再设计分层活动,随后用实战演练验证员工行为,最后通过数据复盘和制度固化形成长效机制。重点覆盖企业员工最常遇到的钓鱼邮件、账号与密码、数据保护、终端使用和内网访问等场景,避免活动停留在横幅、培训和资料发放层面。

从边界到动态:零信任架构的落地逻辑与避坑指南
本文从一条常见的安全建议出发:在远程办公和混合云环境下,‘默认信任内部网络’是危险的。我们拆解这一建议背后的架构逻辑,说明为何需要引入持续验证、最小权限和动态授权。通过梳理身份、终端、策略引擎的协作机制,展示零信任如何替代传统的边界防护。最后,重点讨论实施中的例外与风险:权限过度收紧、策略孤岛和缺乏

2026网络安全法新规:企业合规的底线、红线与落地路径
2026年1月1日起施行的新修订《网络安全法》大幅收紧了网络运营者的合规义务,特别是在等级保护、日志留存、关键信息基础设施(CIIO)管理及法律责任方面。本文从企业实际运营场景出发,拆解核心条款的合规要求,识别高频违规风险点,并提供从差距评估到整改验证的闭环落地方案,帮助企业建立可执行的合规体系。

生成式AI合规实操:从数据治理到服务防护的闭环指南
GB T 45654-2025《生成式人工智能服务安全基本要求》已于2025年11月1日正式实施。本文不再停留在标准条文的复述,而是从技术落地的视角,拆解“数据-模型-服务-评估”全链路的安全控制点。通过梳理训练数据的合规治理、服务侧的多层防护机制以及红队测试的有效性验证,帮助开发者与合规负责人建立


- 热门数据榜
 1
 2
 3
 4
5
6
7
8
9
10
1
2
3
4
5
6
7
8
9
10
1
2
3
4
5
6
7
8
9
10
相关攻略
 2026-10-10 16:31
2026-10-10 16:26
2026-10-10 16:21
2026-10-10 16:16
2026-10-10 16:11
2026-10-10 16:06
2026-10-10 16:01
2026-10-10 15:56
热门教程
- 游戏攻略
- 安卓教程
- 苹果教程
- 电脑教程







