





核心机制:为什么两者的吞吐量天差地别?
理解吞吐量差异,首先要看透它们处理消息的底层逻辑。RabbitMQ遵循AMQP协议,采用Exchange与Queue的路由模型。消息在内存中流转,虽然支持选择性落盘,但其核心瓶颈在于单队列内的锁竞争与上下文切换。它通过Push模式配合预取机制(Prefetch)将数据推给消费者,这种设计牺牲了极限吞吐,换取了低延迟与复杂的路由能力。相比之下,Kafka采用日志追加(Append-Only)的存储模型。它以Topic和Partition为核心,利用操作系统的Page Cache与顺序磁盘I/O实现极高的写入效率。消费者采用Pull模式,可以并行拉取不同分区的数据。简而言之:RabbitMQ为每条消息提供精细的路由与确认,但随机I/O与锁开销限制了上限;Kafka通过批量追加、零拷贝与分区并行化,牺牲了单条消息的极低延迟,换取了海量数据的线性吞吐能力。评估时,必须同时关注吞吐量(单位时间处理数/字节)、延迟(端到端耗时)与可靠性三个维度。
标准化压测环境:如何确保对比公平?
要得到可信的对比数据,必须严格控制变量。我们搭建如下统一环境:
- **硬件**:两台配置相同的Linux服务器(8核CPU,16G内存,NVMe SSD)。
- **软件**:单节点RabbitMQ与Kafka集群。
- **工具**:RabbitMQ使用官方rabbitmq-perf-test,Kafka使用kafka-producer-perf-test。
关键对齐参数如下:
1. **消息体**:设定为1KB、10KB、100KB三档。
2. **并发度**:生产者与消费者线程数均固定为4。
3. **持久化**:RabbitMQ队列设置durable=true;Kafka主题配置6个分区且副本因子为1。
4. **确认机制**:RabbitMQ启用Publisher Confirm;Kafka设置acks=1以平衡吞吐与可靠性。
测试场景分为三类:纯生产压测(仅统计发送速率)、纯消费压测(预置数据后仅拉取)与端到端压测(生产与消费同时运行,统计完整链路延迟)。所有脚本通过环境变量注入参数,确保每次执行可复现。
实测结果:小消息与大文件的性能分水岭
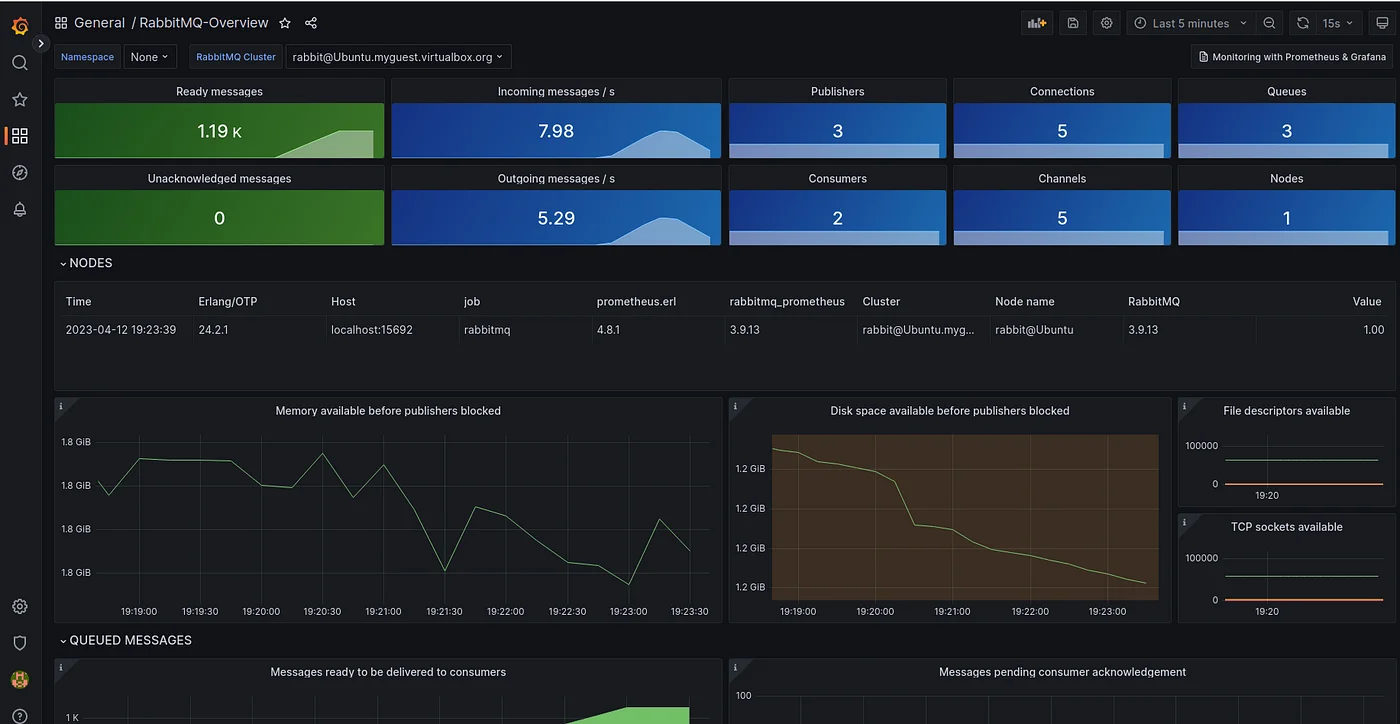
执行压测时,需通过系统监控工具与中间件内置指标同步采集数据。使用iostat监控磁盘I/O利用率与await延迟,top观察CPU用户态与系统态占比,vmstat跟踪内存与上下文切换。RabbitMQ可通过Management UI获取队列深度与确认速率;Kafka则依赖JMX导出BrokerTopicMetrics等指标。
实测对比显示:
- **1KB小消息场景**:RabbitMQ因内存处理优势,延迟稳定在毫秒级,但吞吐受限于单队列锁。Kafka虽然启动开销略大,但凭借零拷贝机制,吞吐迅速攀升。
- **100KB大消息场景**:当消息增大且开启批量发送时,Kafka的顺序写入优势显著,CPU主要消耗在序列化与网络传输,磁盘I/O保持平稳。若开启强持久化,两者吞吐均会下降,但Kafka凭借Page Cache与批量落盘策略,衰减幅度相对可控。
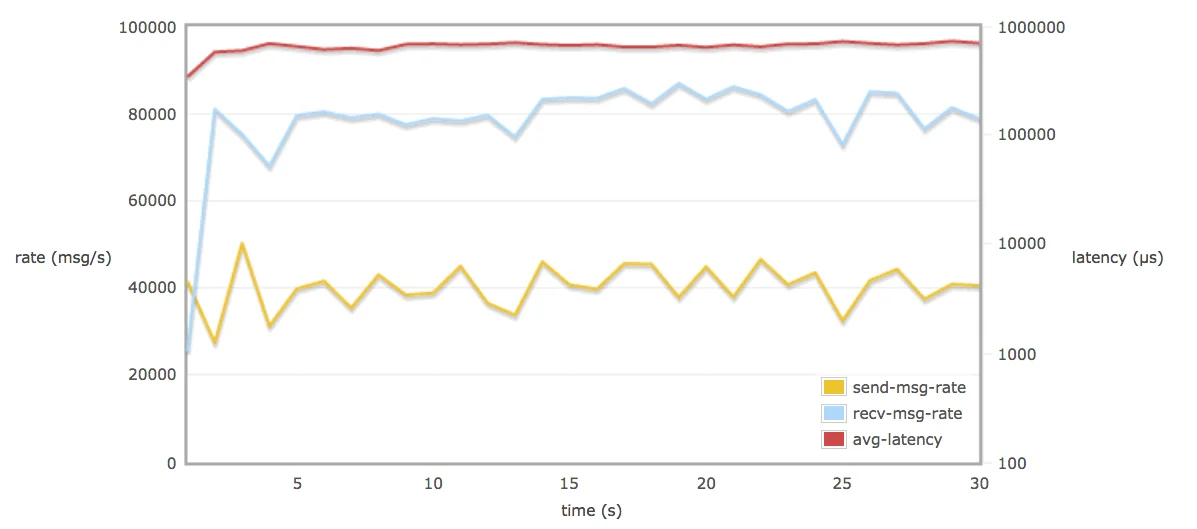
分析时需绘制吞吐曲线与延迟P99分布,避免仅看峰值而忽略长尾效应。
调优指南:生产与消费的关键参数设置
吞吐量调优需遵循先架构后参数、先批量后确认的顺序。以下是关键参数的调优策略:
**Kafka侧:**
- 增加num.partitions以匹配消费者并发度。
- 调整生产者batch.size与linger.ms以聚合请求,减少网络往返。
- 启用compression.type=snappy降低网络与磁盘带宽压力。
- 消费者端调大fetch.min.bytes与max.poll.records减少拉取频次。
**RabbitMQ侧:**
- 合理设置prefetch_count(建议100至500),避免单条确认导致的频繁网络往返。
- 启用Publisher Confirm的异步批量模式。
- 针对大流量场景配置x-queue-mode=lazy将消息直接落盘,减轻内存压力。
- 关闭非必要的镜像队列以降低同步开销。
验证方法为:每次仅调整单一参数组,运行标准化压测脚本,观察吞吐曲线是否趋于平稳且延迟未突破业务阈值,最终形成参数基线。
避坑与选型:何时该用谁?
压测避坑需警惕五大误区: 1. **硬件环境不一致**:导致结果失真,无法横向对比。 2. **未统一消息大小**:误将大文件传输与文本指令对比,失去参考意义。 3. **确认机制不对等**:如将RabbitMQ异步确认与Kafka同步刷盘直接比较。 4. **仅测试生产端**:忽略消费端积压与反压能力,导致线上OOM。 5. **忽视数据可靠性**:在追求极限吞吐时关闭持久化或ACK,导致压测结果脱离生产实际。 **选型结论:** - **选Kafka**:若场景为日志采集、指标上报、实时数仓等海量数据流,且容忍秒级延迟。其高吞吐与生态优势无可替代。 - **选RabbitMQ**:若业务涉及订单状态流转、支付通知、复杂路由匹配,要求严格的消息顺序、事务支持与毫秒级响应。其AMQP模型与灵活队列机制更为契合。 最终决策需综合吞吐量、延迟、可靠性与运维成本,避免单一指标导向。







