





理解defaultdict与Counter的定位和适用场景
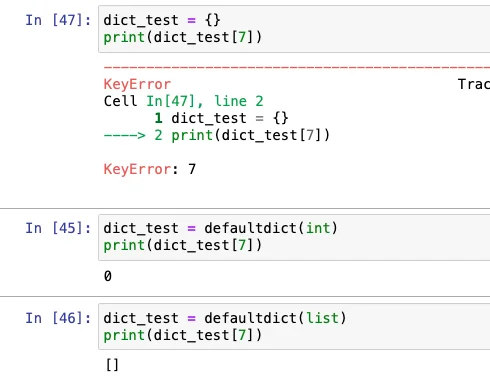
在Python标准库collections中,defaultdict与Counter是处理字典数据的利器。普通字典在访问不存在的键时会抛出KeyError,而defaultdict通过接收一个默认工厂函数(如list、int或set)在初始化时自动处理缺失键,访问时若键不存在则调用该函数生成默认值并插入字典,从而彻底避免异常中断。Counter则专为可哈希对象的频次统计设计,底层继承自dict,但内置了高效的计数逻辑与数学运算接口。三者的适用边界清晰:若仅需简单的键值映射且需严格校验键的存在性,使用普通dict;若涉及动态分组、嵌套结构或频繁追加元素,defaultdict能大幅简化if key not in d的样板代码;若核心需求是词频统计、元素计数或基于频次的排序筛选,Counter则是首选。合理选择工具可显著提升代码的可读性与执行效率。
使用defaultdict实现分组与默认值处理
使用defaultdict进行数据分组时,首先需从collections导入并传入工厂函数。例如按首字母对单词列表分组:d = defaultdict(list),遍历单词执行d[word[0]].append(word)即可自动创建列表并追加,无需预先判断键是否存在。若需去重分组,可传入set工厂;若进行数值累加,传入int工厂后直接执行d[key] += value,缺失键默认初始化为0。相比之下,普通字典需借助setdefault方法,如d.setdefault(key, []).append(value),虽然功能等效,但每次访问都会重复执行默认值创建逻辑,在循环中性能略逊且代码冗长。defaultdict将默认值逻辑下沉至底层实现,访问速度更快。实际开发中,建议根据数据结构类型精准选择工厂函数,避免混用导致类型不一致的隐患。
使用Counter完成统计、排序与集合运算
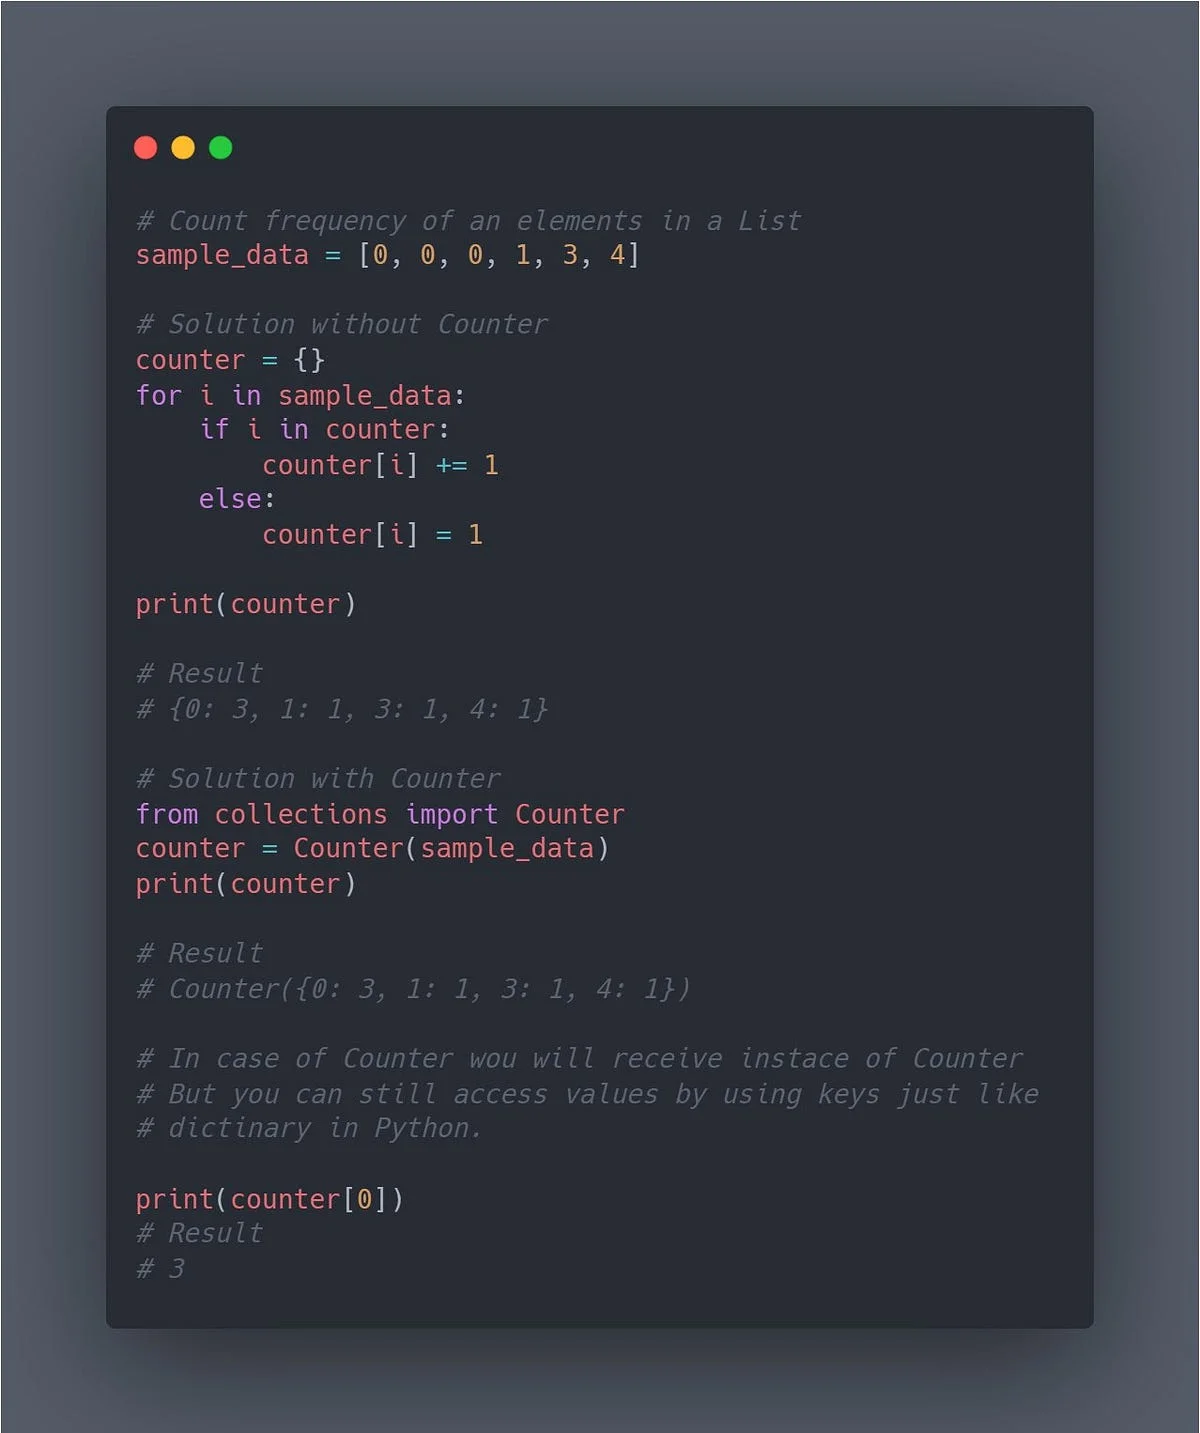
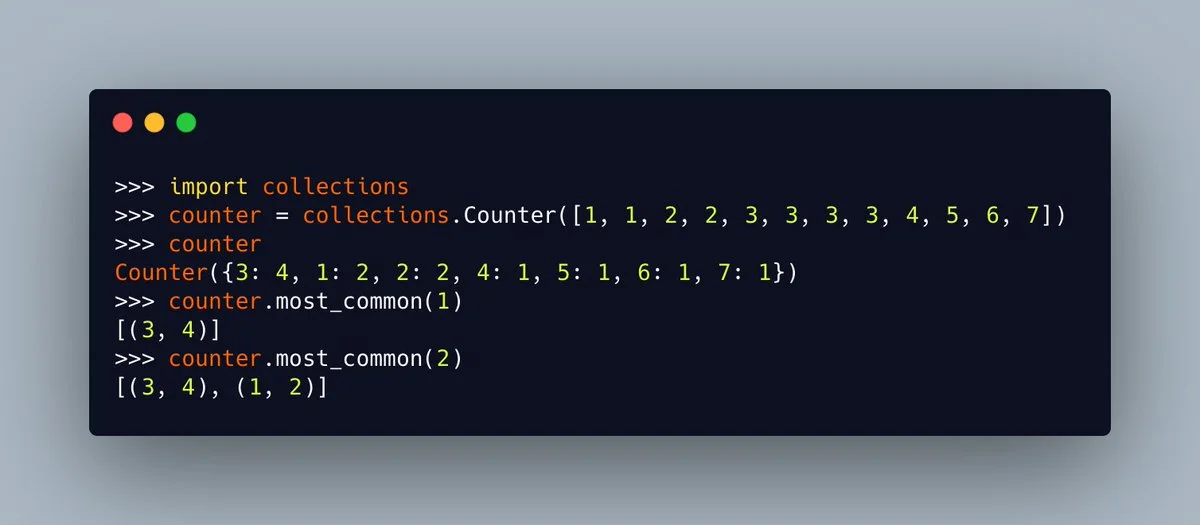
Counter的创建极为灵活,可直接传入可迭代对象、映射或关键字参数。例如统计文本词频:c = Counter("apple banana apple orange"),结果自动记录各词出现次数。通过c.most_common(n)可快速获取频次最高的前n个元素,返回按频次降序排列的元组列表。元素访问支持直接索引,如c["apple"]返回对应计数;若键不存在,Counter会静默返回0而非报错,便于安全查询。更新数据可使用c.update(iterable)累加计数,或使用c.subtract(iterable)扣减计数。Counter还支持丰富的集合与算术运算:c1 + c2合并计数,c1 - c2仅保留正数结果,c1 & c2取交集(最小值),c1 | c2取并集(最大值)。这些内置方法让多维统计与数据聚合无需手动编写循环,代码高度凝练。
验证结果并避开defaultdict与Counter常见坑
在实际验证中,defaultdict与Counter的隐式行为可能引发难以察觉的Bug。defaultdict在读取不存在的键时会自动调用工厂函数创建新键,若仅用于查询而非写入,会导致字典体积意外膨胀,此时应改用dict.get()或普通字典。Counter对缺失键返回0虽方便,但在执行减法或过滤时,若结果小于等于0,该键仍会保留在字典中,直接遍历可能产生无效数据。可通过正号运算符或elements()方法过滤非正数项,或使用c = +c清除零负值。此外,当业务逻辑要求严格区分未出现与出现0次,或需要保持插入顺序且无需默认值时,普通dict仍是更稳妥的选择。编写单元测试验证边界条件,能有效规避此类陷阱。







