





定位内存瓶颈:先测量再动手
在优化大规模数据集之前,首要任务是建立准确的内存基线。Pandas 提供的 df.info(memory_usage='deep') 方法能够递归计算对象引用的实际内存,而非仅返回指针大小。通过 df.memory_usage(deep=True) 可以获取每一列的具体字节数,从而精准定位内存消耗大户。通常,object 类型是内存泄漏的重灾区,因为 Pandas 将其存储为 Python 原生对象数组,每个元素都包含独立的内存开销和引用计数。此外,默认的 int64 和 float64 在数据范围较小时会造成严重浪费,例如仅包含 0-255 的整数列仍占用 8 字节。通过绘制各列内存占比的柱状图,可以直观发现哪些列需要优先处理。只有建立清晰的内存基线,后续的优化策略才能有的放矢,避免无效操作。

数据类型优化:用合适的 dtype 降低占用
明确瓶颈后,可通过调整数据类型显著压缩内存。对于数值列,可使用 pd.to_numeric(df['col'], downcast='integer') 或 downcast='float',将 int64 降级为 int32/int16,float64 降级为 float32。但需注意,降级会缩小取值范围,超出范围将引发溢出错误,且 float32 的精度约为 7 位有效数字,金融或科学计算中需谨慎评估。对于包含大量重复文本的列(如省份、状态码),将其转换为 category 类型可节省 50% 至 90% 的内存,因为底层仅存储整数编码和唯一的类别字典。日期列应统一使用 pd.to_datetime() 转为 datetime64[ns],避免保留为字符串。操作时必须警惕缺失值(NaN)的影响:Pandas 的整数类型原生不支持 NaN,若列中存在空值,强制转为 Int32(可空整数)或保留浮点类型是更稳妥的选择,否则会导致类型转换失败或数据丢失。

分块读取大文件:避免一次性加载
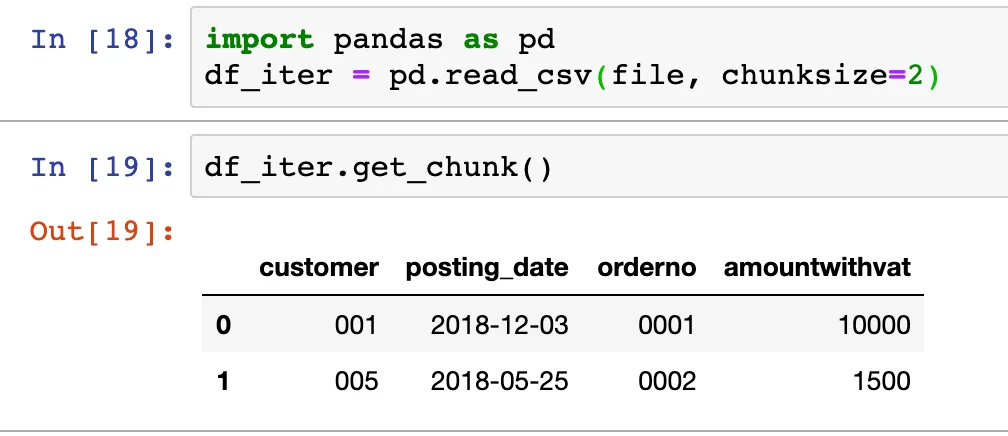
当数据文件体积远超可用内存时,必须采用分块读取策略。Pandas 的 pd.read_csv() 支持 chunksize 参数,返回一个可迭代的 TextFileReader 对象。典型处理模式是初始化一个累加器或空 DataFrame,遍历每个块进行过滤、聚合或清洗,最后合并结果。例如,统计某列的总和或频次时,可在循环内对当前块执行 groupby 或 sum(),并将中间结果累加至全局变量。块大小的选择需权衡 I/O 开销与内存峰值:过小会导致频繁的文件读取和函数调用开销,过大则可能触发内存溢出。通常建议从 10 万到 50 万行起步,结合 sys.getsizeof() 监控单块内存,动态调整至占可用内存 10%~20% 的区间。若需保留完整数据而非仅做聚合,可结合 dask 或数据库写入,避免在内存中拼接超大 DataFrame。
验证优化效果与常见避坑
优化完成后,必须进行严格的验证以确保数据完整性与计算一致性。首先对比优化前后的 df.memory_usage(deep=True).sum(),确认内存下降幅度符合预期。其次,使用 df.shape 和 df.dtypes 核对行数、列数及字段类型是否发生非预期变更。对于关键指标(如总和、均值、唯一值计数),需通过 np.isclose() 或容差比较验证优化前后结果是否一致。常见陷阱包括:过度压缩导致数值截断或溢出,例如将含小数的金额列误转为 int16;滥用 category 类型处理高基数列(如用户 ID),反而增加字典开销;分块处理时因未正确设置索引或过滤条件导致数据重复统计或遗漏。建议在优化流程末尾加入自动化校验脚本,记录内存峰值、类型映射表与核心指标偏差,确保生产环境的数据可靠性。







