理解 Python 集合与基本运算规则
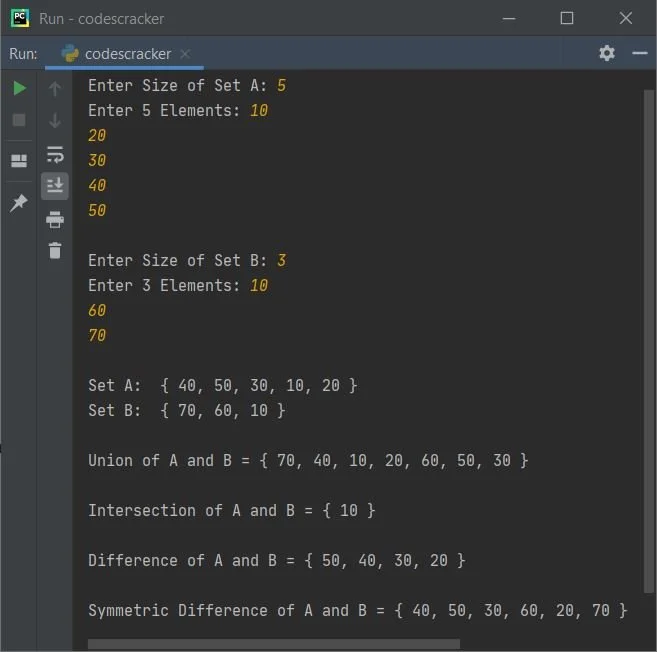
Python 中的集合(set)是一种内置的无序且不包含重复元素的数据结构。其核心特性在于元素唯一性与无序性,这意味着集合会自动剔除重复项,且不支持索引访问。集合运算主要包含四种基础操作:交集表示同时存在于两个集合中的元素,对应数学中的“且”关系;并集表示合并两个集合的所有元素并去重,对应“或”关系;差集表示存在于第一个集合但不存在于第二个集合的元素,体现“排除”逻辑;对称差集则包含仅属于其中一个集合的元素,即剔除两者共有的部分。理解这些规则是进行高效数据筛选的前提,开发者可通过花括号或set函数快速构建集合,并利用直观的数学逻辑映射到代码实现中。
掌握交集、并集与差集的常用写法
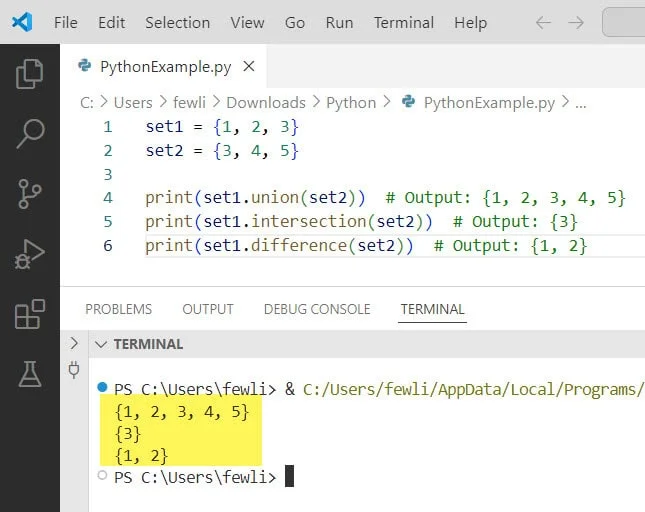
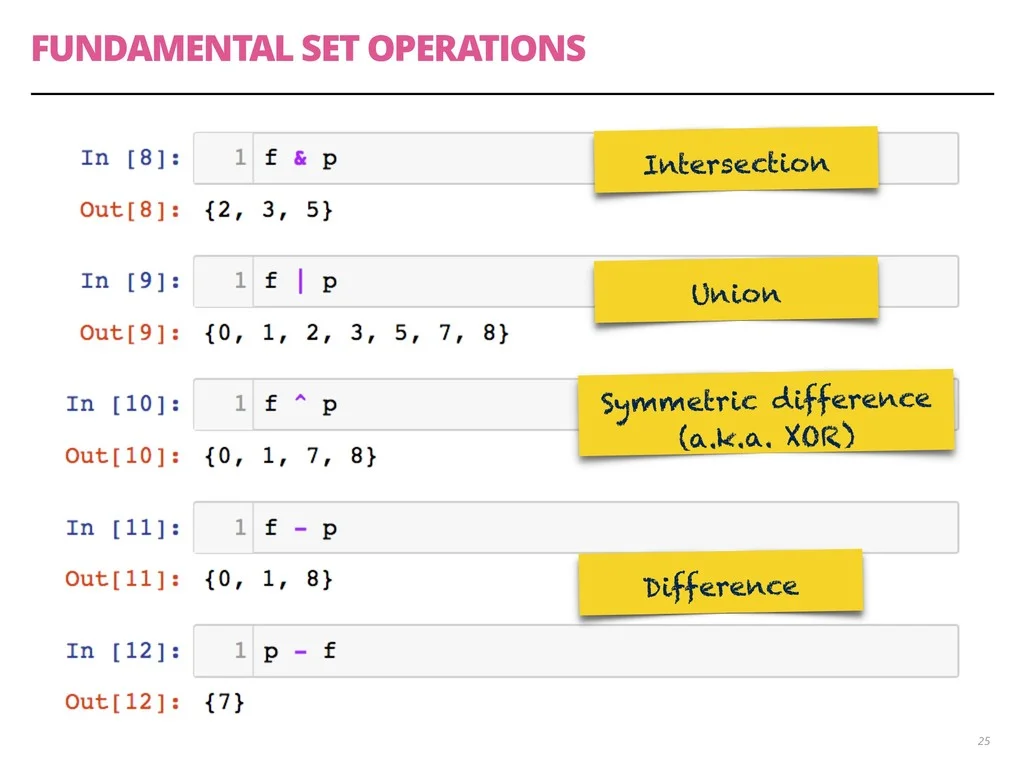
在Python中,集合运算既可通过运算符实现,也可调用内置方法。交集使用&或intersection,并集使用|或union,差集使用-或difference,对称差集使用^或symmetric_difference。运算符要求两侧均为集合类型,而方法支持传入任意可迭代对象,灵活性更高。多集合运算可直接链式调用,例如连续使用交集运算符可一次性获取多个集合的公共元素。需要特别注意的是,所有运算符与方法均不会修改原始集合,而是返回全新的集合对象。这种设计保证了数据源的安全性,便于在复杂的数据处理流水线中进行多次组合运算而不产生副作用。
结合实际数据场景完成集合筛选
集合运算在实际业务数据处理中应用广泛。在用户去重场景中,将多来源的用户ID列表转为集合后求并集,即可快速获得全局唯一用户池。权限比较常使用交集提取两个角色共有的操作权限,或使用差集找出某角色缺失的权限项。标签筛选则依赖交集运算,例如从海量商品中筛选同时具备特定标签的SKU。数据差异分析多采用差集,如对比新旧版本配置文件,旧配置减去新配置可定位被移除的字段,新配置减去旧配置则发现新增项。选择何种运算取决于业务目标:求共性选交集,求全集选并集,找差异选差集,明确需求可大幅提升代码可读性与执行效率。
验证运算结果并规避常见错误
验证集合运算结果时,建议结合type确认返回类型,使用len核对元素数量,并通过in关键字进行成员关系抽查,确保逻辑符合预期。常见避坑点包括:一是类型混用,列表与集合直接使用运算符会抛出TypeError,需先显式转换;二是误以为重复元素丢失是Bug,实为集合的固有特性,若需保留重复项应改用列表;三是差集方向错误,A减B与B减A结果截然不同,务必根据业务语义确认减数与被减数;四是混淆原地修改与返回新集合,update等方法会改变原对象,而运算符始终生成新对象。掌握这些细节可有效避免数据污染与逻辑偏差。