理解 memory-profiler 与逐行内存分析机制
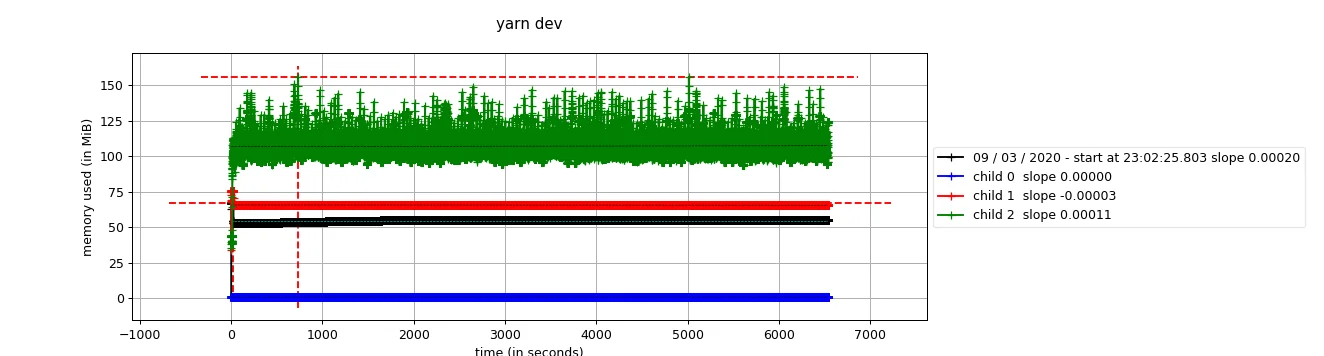
memory-profiler 是 Python 生态中一款轻量级但功能强大的内存分析工具,其核心能力在于对函数内部每一行代码执行时的内存占用进行精确采样与追踪。该工具底层依赖 psutil 库获取进程内存信息,并通过 Python 的 sys.settrace 机制在代码执行过程中拦截每一行指令,记录当前时刻的 RSS 常驻内存值。开发者只需在目标函数上方添加 @profile 装饰器,即可在不修改业务逻辑的前提下开启逐行监控。分析过程中,工具会对比相邻代码行的内存快照,计算出增量与该行被执行的次数,从而直观暴露出导致内存突增的具体语句。这种逐行追踪机制特别适用于定位列表动态扩容、大文件一次性加载或循环内频繁创建临时对象等典型内存消耗场景,为后续的性能调优提供精确的数据锚点。
安装配置并执行逐行内存分析
使用 memory-profiler 前需通过包管理器完成安装,推荐在虚拟环境中执行 pip install memory-profiler 以隔离依赖。该工具无需额外配置文件,核心配置仅体现在代码层面:在需要分析的函数定义前添加 @profile 装饰器,并确保该函数在脚本入口被调用。执行分析时,不建议直接运行 python script.py,而应使用模块调用方式 python -m memory_profiler script.py,这样工具会自动拦截并注入追踪逻辑。若需分析多进程或异步代码,可结合 mprof run script.py 生成时间序列数据文件。执行完毕后,终端会逐行打印内存快照报告。例如,针对一个包含数据读取与处理的脚本,只需在函数上方标记装饰器,运行命令后即可在控制台直接查看每一行代码执行前后的内存变化,整个过程对原有代码侵入性极低,且支持直接通过 @profile(precision=4) 调整输出精度。
解读逐行报告并定位内存热点
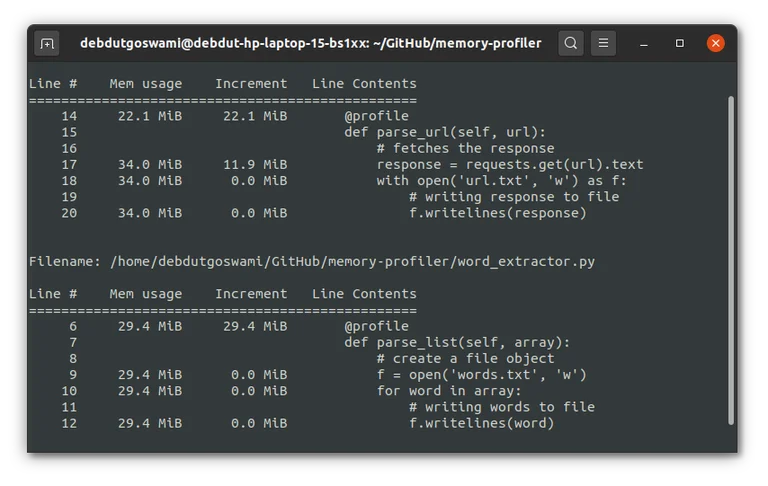
运行分析命令后,终端输出的逐行报告包含五个核心字段:Line 代码行号、Mem usage 当前行执行后的累计内存占用、Increment 相较于上一行的内存变化量、Occurrences 该行被执行的次数以及 Line Contents 源码内容。解读时需重点关注 Increment 为正值且数值较大的行,这通常意味着内存热点。例如,当某行执行 data = [x for x in range(1000000)] 时,Increment 可能显示为正值,直接暴露了列表推导式一次性分配大量内存的行为;若后续出现 data = None 或 del data,Increment 会显示负值,表明内存被释放。此外,Occurrences 字段能辅助判断循环体内的内存泄漏风险:若某行在循环中反复执行且 Increment 持续为正,说明存在未回收的临时对象或引用未解除。通过交叉比对 Mem usage 的累积趋势与具体代码逻辑,可快速定位到数据加载、缓存堆积或对象未释放等瓶颈位置。
优化内存占用并验证效果
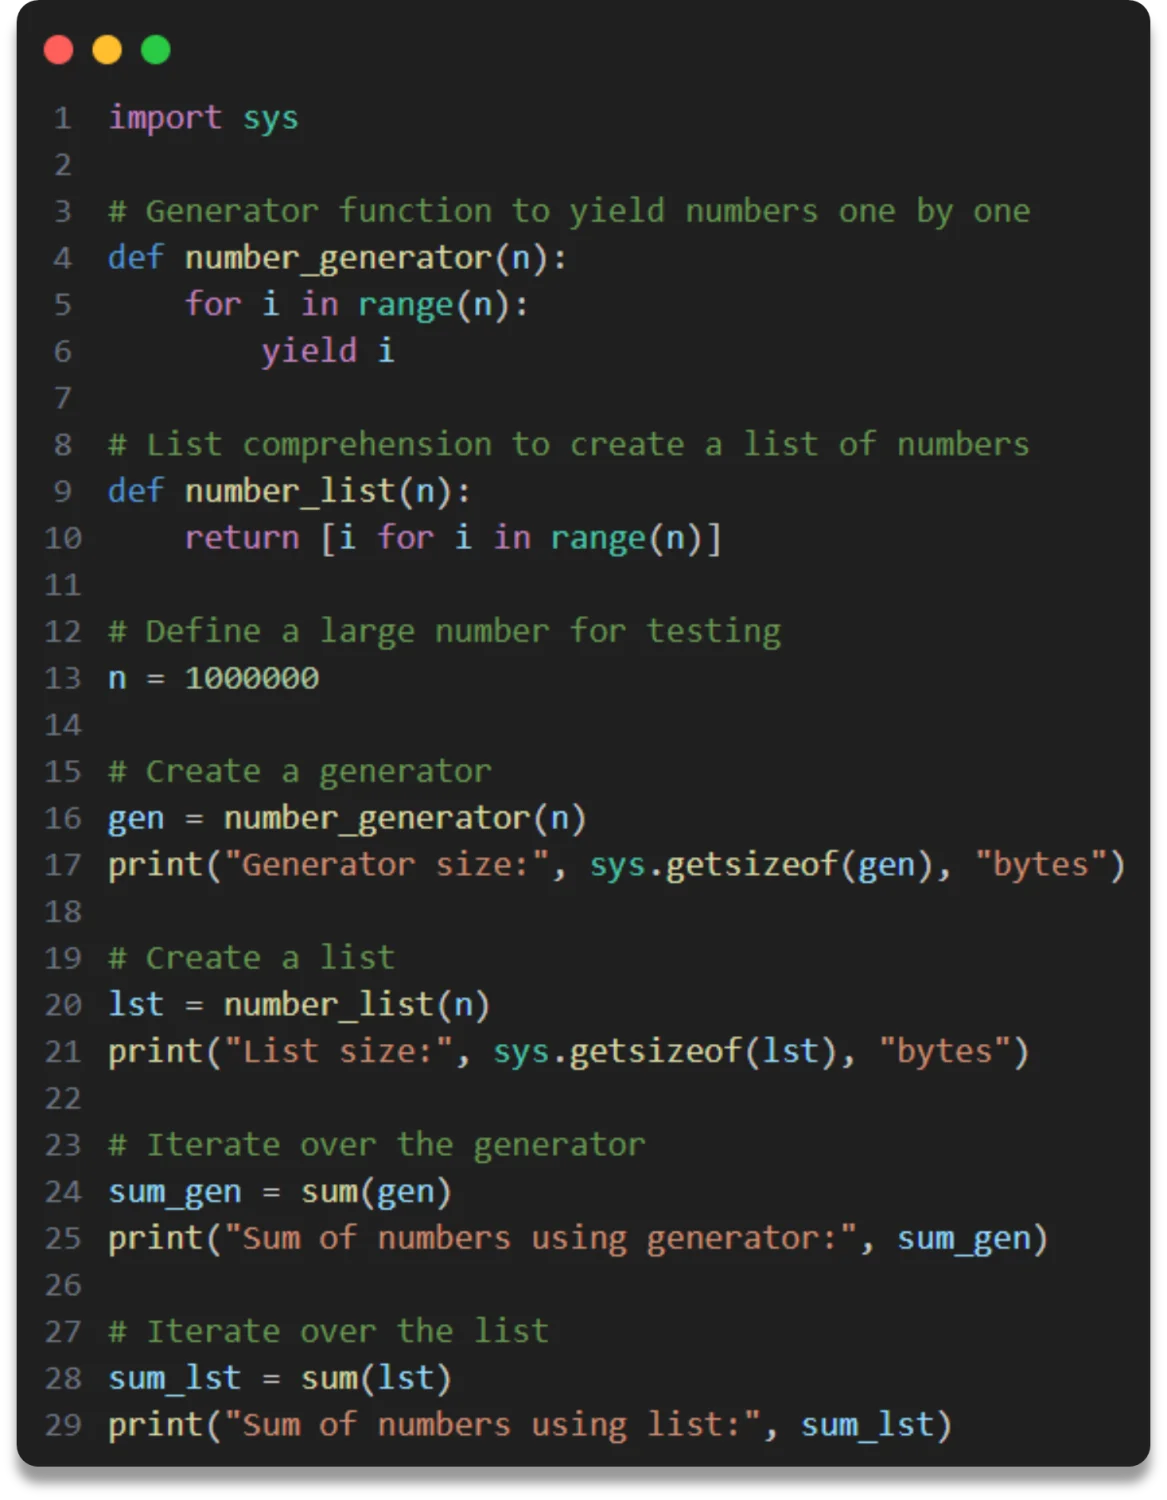
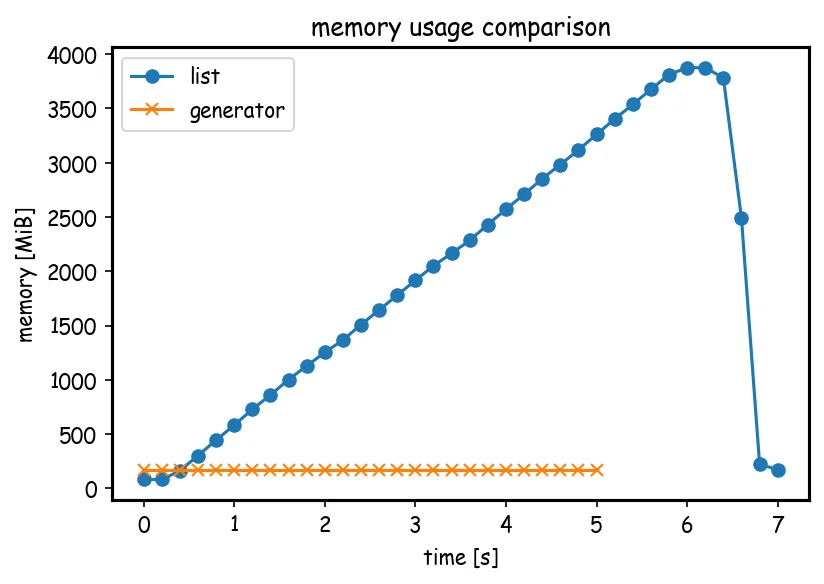
定位到内存热点后,需结合业务场景实施针对性优化。对于一次性加载大数据导致的内存峰值,可改用生成器表达式或 yield 关键字实现惰性求值,将列表推导式替换为逐行读取的迭代器模式;对于数值型数组,优先使用 array 模块或 numpy 替代原生 list,以降低对象头开销。优化完成后,必须重新运行 python -m memory_profiler script.py 进行效果验证。对比优化前后的报告,若原热点行的 Increment 从高位降至接近零,且整体 Mem usage 曲线趋于平稳,则证明优化生效。若内存仍持续增长,需检查是否存在闭包引用、全局变量累积或第三方库缓存未清理。通过分析、优化、复测的闭环流程,可确保内存改进具备可量化依据,避免盲目重构引入新缺陷。
常见误区与实际项目中的使用边界
尽管 memory-profiler 在开发调试阶段极为高效,但实际应用中需明确其边界。首先,逐行追踪依赖 sys.settrace,会显著增加 CPU 开销与执行时间,因此严禁在生产环境或高并发服务中直接启用,仅适用于离线脚本或测试环境。其次,该工具基于 CPython 实现,对 PyPy 等 JIT 解释器或底层 C 扩展的内存分配追踪存在盲区,此时需结合 tracemalloc 或 objgraph 进行对象级分析。此外,它擅长捕捉短期内存峰值与显式分配,但对长期运行中的缓慢内存泄漏敏感度有限,建议配合 guppy3 或 filprofiler 进行堆快照对比。在工程实践中,应将其作为内存调优的显微镜而非监控仪,合理搭配日志采样与压测工具,方能构建完整的内存治理体系。