





理解 @property 的访问拦截机制
在 Python 中,直接暴露实例属性(如 self.name = 'Alice')虽然便捷,但允许外部代码随意修改内部状态,破坏了封装性。@property 装饰器的核心价值在于将普通方法转换为属性访问接口。调用者无需使用括号(即 c.area 而非 c.area()),即可像访问字段一样获取数据,但底层仍执行方法逻辑。这种机制提供了拦截访问的能力:getter 负责返回计算结果或内部值,setter 负责拦截赋值操作并执行逻辑,deleter 则处理 del 语句触发的清理。三者共同构成了完整的属性生命周期管理,使开发者能在不改变外部调用接口的前提下,平滑升级类的内部实现。
实现只读与受控的可写属性
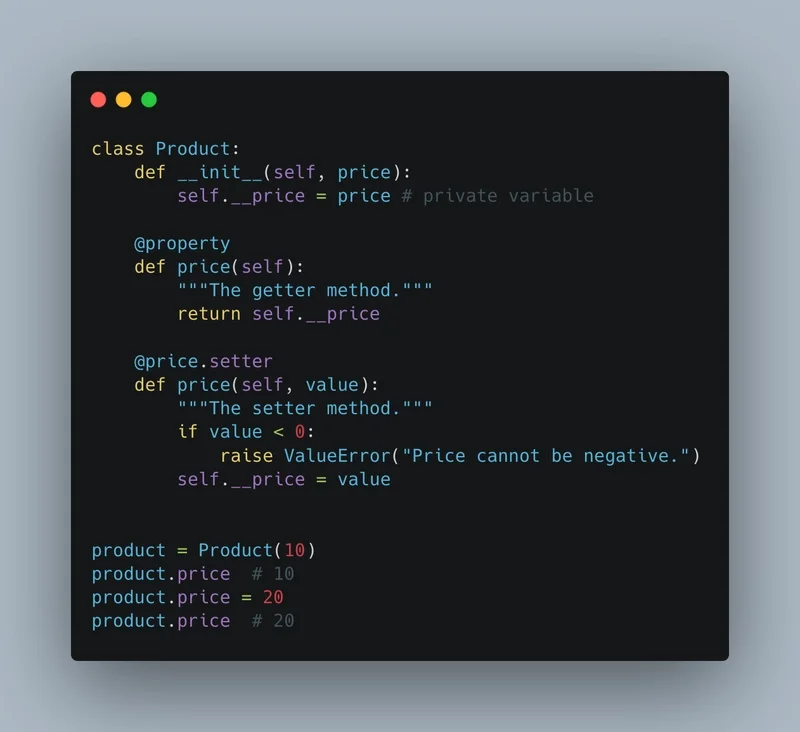
实现只读属性时,只需在方法上方添加 @property 装饰器。例如,定义一个 Circle 类,通过 @property 暴露 area 属性,外部调用 c.area 时会自动执行面积计算逻辑,且无法直接赋值修改。若需开放受控写入,可配合 @属性名.setter 装饰器定义同名方法。按照 Python 惯例,实际存储数据的变量通常以下划线开头(如 _radius),以表明其为受保护的内部状态。在 setter 方法中,通过 self._radius = value 完成赋值,既保留了属性访问的直观语法,又确保了底层数据始终通过受控通道更新,实现了读写分离与状态保护。
利用 setter 实施数据校验与约束
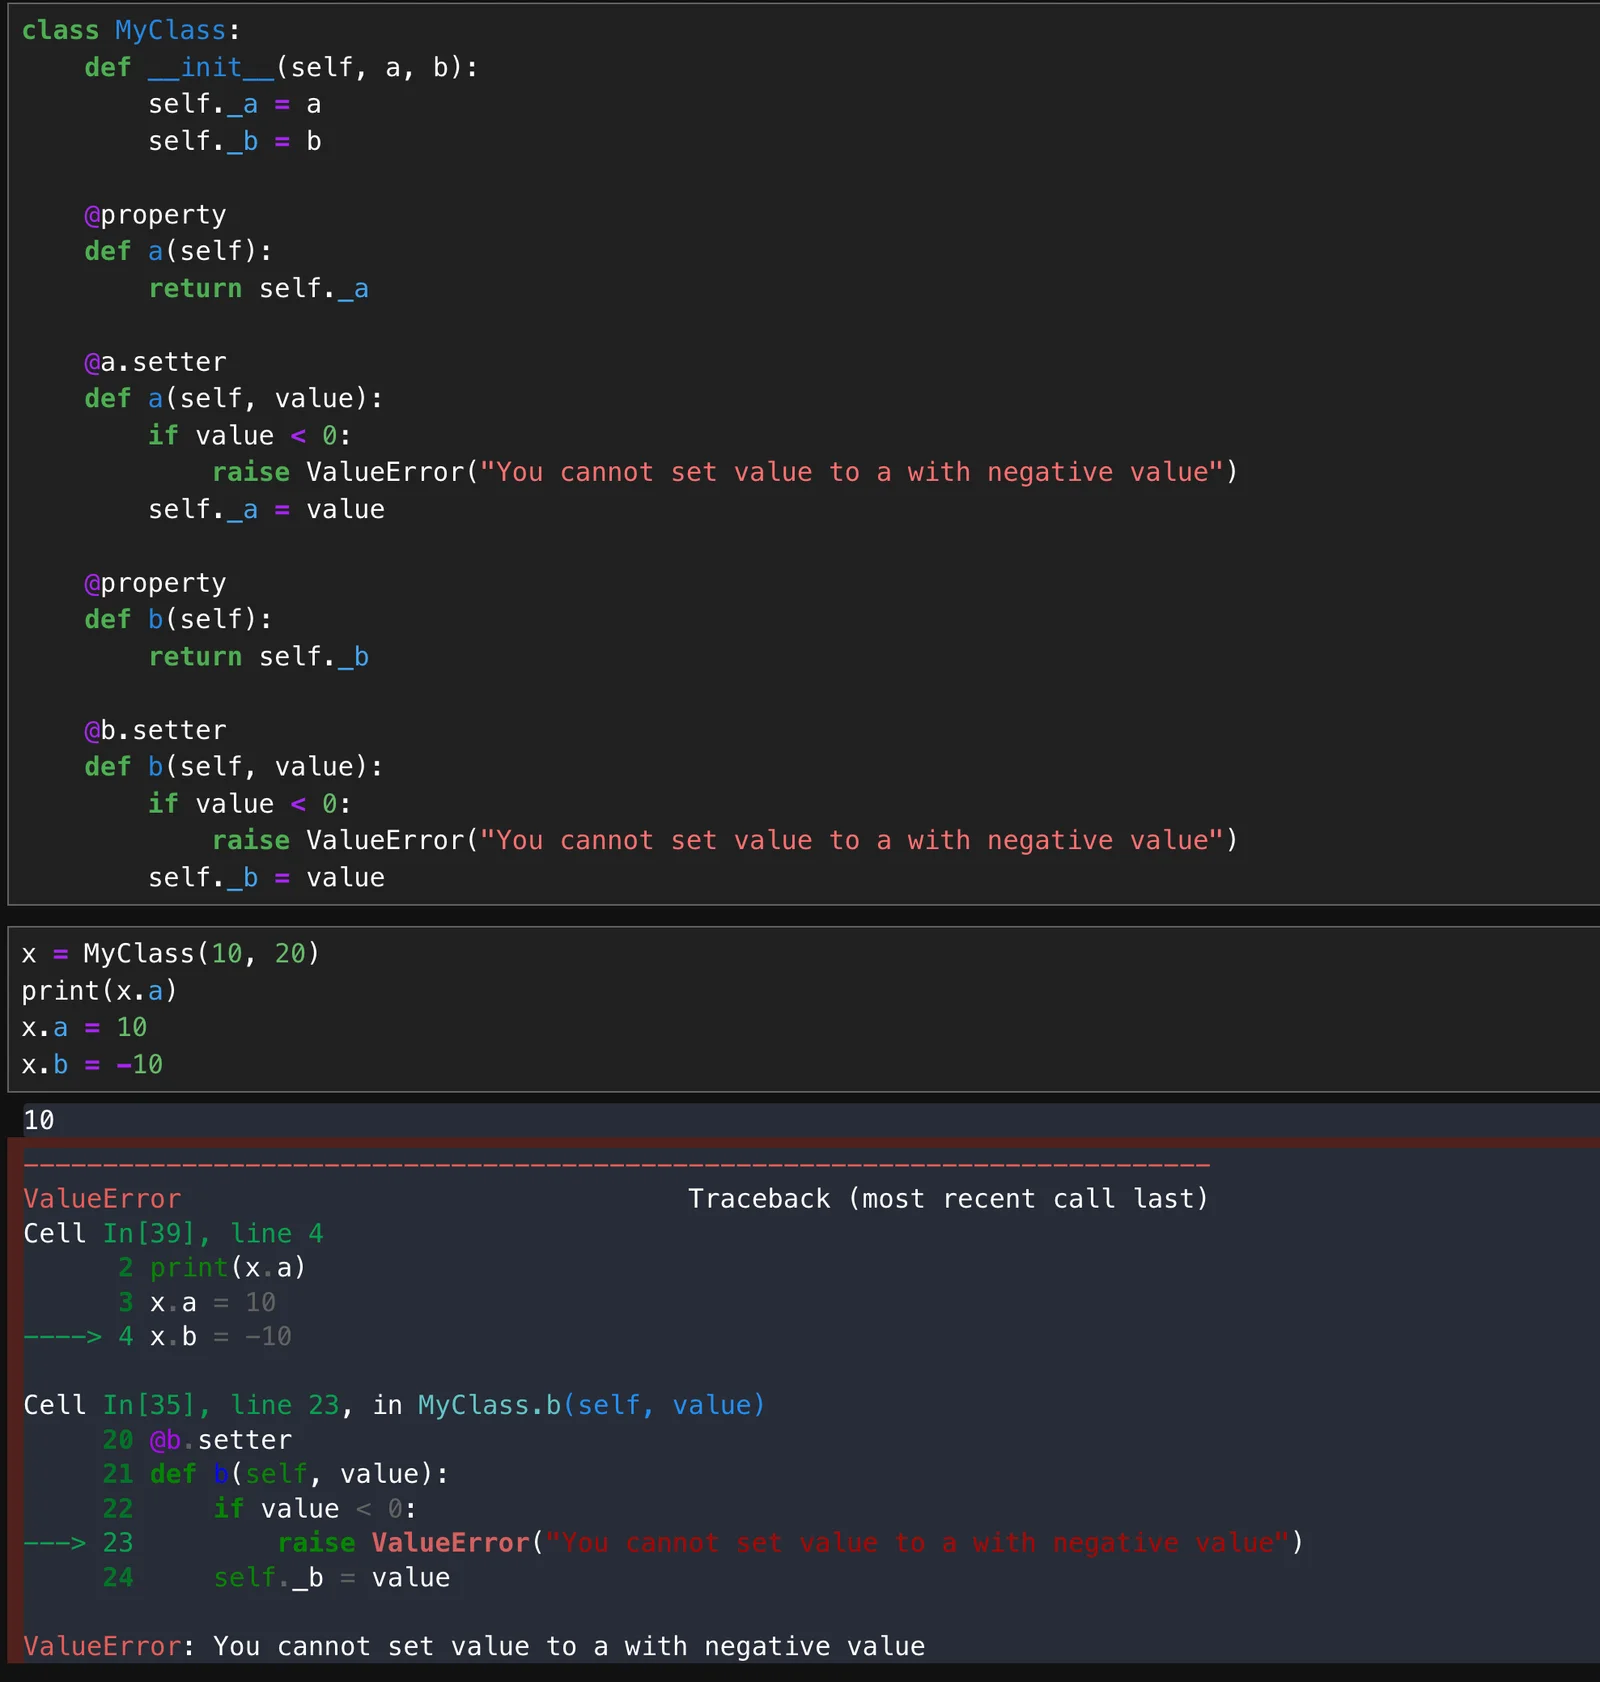
在实际业务开发中,直接赋值往往会导致非法数据污染对象状态。借助 @property.setter,可以在赋值入口集中实施数据校验。以用户年龄为例,setter 可首先检查输入是否为整数,随后验证其是否处于合理区间(如 0 至 150)。若校验失败,应主动抛出 ValueError 异常并附带明确提示,阻止非法值写入。同理,商品价格属性可拦截负数或非数字类型。这种设计强制所有状态变更必须经过统一入口,避免了在类外部多处编写重复的校验逻辑。通过受控入口维护对象状态,不仅提升了代码的健壮性,也确保了业务规则的一致性,是防御性编程的重要实践。
验证行为与避开常见陷阱
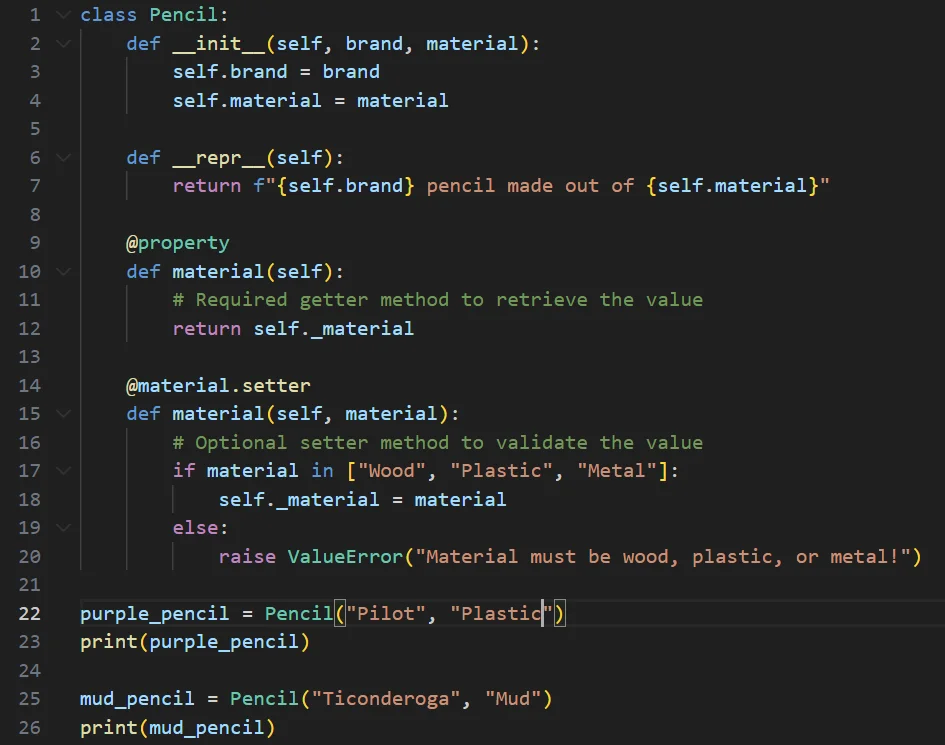
验证 @property 行为时,可通过交互式解释器或 unittest 框架逐一测试读取、赋值、删除及异常分支。例如,尝试对只读属性赋值会触发 AttributeError,而传入非法值则应捕获到预设的 ValueError。开发中需警惕常见陷阱:其一是递归调用,若在 setter 中错误使用 self.attr = value 而非 self._attr = value,会无限触发 setter 自身导致栈溢出;其二是内部变量命名冲突,若未使用下划线前缀,可能覆盖原有属性;其三是过度使用,将简单字段全部包装为 property 会增加维护成本;其四是 setter 副作用,应避免在赋值时执行耗时 I/O 或修改无关状态,保持属性访问的纯粹性与可预测性。







